Trình duyệt nói gì với máy chủ?
Trình duyệt phải nói gì để máy chủ nào cũng hiểu?
TCP đã đưa được dữ liệu tới đúng chương trình trên máy chủ. Nhưng TCP chỉ chở byte. Nó không quy định hai chương trình phải nói gì với nhau.
Trình duyệt do người này viết, máy chủ do người khác viết, mỗi bên chạy trên một loại máy. Muốn hiểu nhau, hai bên phải thống nhất trước: hỏi thế nào, trả lời thế nào.
Trình duyệt phải nói gì để máy chủ nào cũng hiểu?
Tài liệu nằm trên những máy không hiểu nhau
Năm 1989, ở CERN, trung tâm nghiên cứu vật lý hạt ở châu Âu, đây là một vấn đề thật.
Vài nghìn người làm việc ở đó. Mỗi người thường ở khoảng hai năm rồi đi. Theo Tim Berners-Lee, một nhà khoa học người Anh làm ở CERN, “thông tin liên tục bị mất”: tài liệu có viết ra, nhưng không ai tìm được.
Cái khó là tài liệu nằm trên đủ loại máy: VM/CMS của IBM, Macintosh, VAX/VMS, Unix. Mỗi loại lưu tệp theo cách riêng, và máy này không đọc được tệp của máy kia.
Cách dễ nghĩ nhất là gom hết về một máy. Berners-Lee cho rằng không làm vậy được: nếu CERN đứng yên thì “mọi thông tin có thể viết vào một cuốn sách lớn”, nhưng CERN thay đổi liên tục, nhóm nào cũng có máy riêng và cứ thế mọc thêm.
Để tài liệu ở yên, rồi nối chúng lại
Tháng 3/1989, ông viết bản đề xuất Information Management: A Proposal. Ý chính: tài liệu cứ nằm ở máy của nhóm làm ra nó. Trong tài liệu có những liên kết (link) trỏ sang tài liệu khác, ở bất kỳ máy nào.
Văn bản có liên kết như vậy gọi là siêu văn bản (hypertext). Không cần một máy trung tâm nào quản lý cả.
Nhưng liên kết chỉ là một địa chỉ ghi trong trang. Khi người đọc bấm vào, máy của họ phải tự đi xin tài liệu đó từ một máy khác, có khi là một loại máy hoàn toàn khác.
Một máy Macintosh phải hỏi thế nào để máy VAX hiểu?
Câu hỏi đầu tiên chỉ là một dòng chữ
Cuối năm 1990, Berners-Lee đã chạy được hai chương trình:
- máy chủ web (web server): giữ tài liệu và gửi cho ai xin;
- trình duyệt (browser): xin tài liệu rồi hiện lên màn hình.
Máy chủ đầu tiên tên info.cern.ch, chạy trên một máy NeXT đặt trong phòng ông.
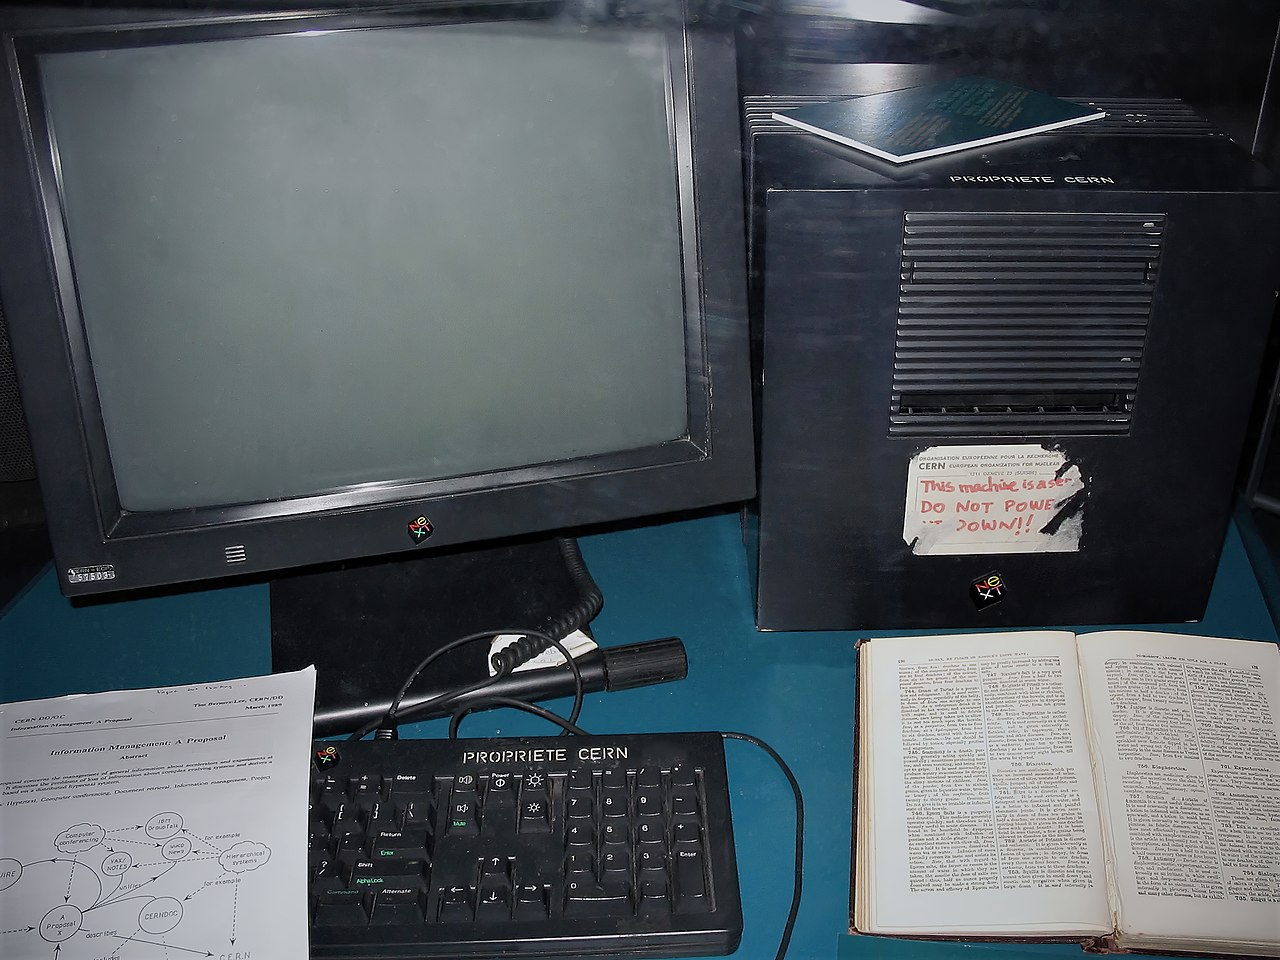
Cách hai chương trình hỏi và đáp nhau được đặt tên là HTTP (HyperText Transfer Protocol, giao thức truyền siêu văn bản). Theo bản mô tả năm 1991, trình duyệt mở một kết nối TCP tới máy chủ, mặc định ở cổng 80, rồi gửi đúng một dòng:
GET /hypertext/WWW/TheProject.htmlGET nghĩa là “lấy”. Phần sau là đường dẫn tới tài liệu trên máy chủ, ở đây là trang web đầu tiên.
Máy chủ gửi lại nội dung trang, viết bằng HTML: chữ thường, kèm những dấu đánh dấu chỗ nào là tiêu đề, chỗ nào là liên kết. Gửi xong, máy chủ cắt kết nối.
Vì sao cách này chạy được trên mọi loại máy? Vì cả câu hỏi lẫn câu trả lời đều chỉ là chữ ASCII. Máy Macintosh không cần biết VAX lưu tệp ra sao. Nó chỉ cần gửi một dòng chữ và đọc chữ gửi về.
Máy nào đọc được chữ thì nói được HTTP.
Nhưng câu trả lời chỉ có nội dung, không có gì cho biết việc xin đã thành hay hỏng. Khi có lỗi, máy chủ cũng gửi về một trang chữ, lần này là lời giải thích lỗi. Bản 1991 ghi rõ: không có cách nào phân biệt câu trả lời lỗi với câu trả lời đúng, trừ khi đọc nội dung.
Người đọc thấy chữ “không tìm thấy” thì hiểu. Trình duyệt thì không: với nó, đó vẫn chỉ là một trang như mọi trang khác.
Web lớn lên, câu hỏi phải nói rõ hơn
Ngày 30/4/1993, CERN cho phép ai cũng được dùng, sửa và phát lại phần mềm web mà không phải xin phép. Cuối năm 1993 đã có hơn 500 máy chủ web được biết tới. Cuối 1994 có 10.000, trong đó 2.000 là máy chủ thương mại.
Nhiều website như vậy thì không phải website nào cũng có một máy riêng. Một máy chủ thường giữ nhiều website cùng lúc, tất cả chung một địa chỉ IP.
Lúc đó câu hỏi kiểu 1991 không còn đủ. Một yêu cầu GET / tới máy đó là xin trang chủ, nhưng trang chủ của website nào?
Một yêu cầu HTTP ngày nay vì thế có thêm vài dòng:
GET /hello HTTP/1.1
Host: example.com
Dòng đầu vẫn là câu hỏi cũ: lấy (GET) thứ nằm ở đường dẫn /hello. Cuối dòng ghi phiên bản HTTP mà trình duyệt đang dùng.
Dòng thứ hai, Host, là tên website. Địa chỉ IP đưa yêu cầu tới đúng máy. Dòng Host chỉ ra đúng website trên máy đó.
GET dùng để xin về. Khi cần gửi dữ liệu lên, ví dụ bấm nút đăng nhập, trình duyệt dùng POST: email và mật khẩu nằm trong chính yêu cầu đó.
Câu hỏi đã rõ hơn. Nhưng câu trả lời vẫn vướng đúng chỗ của bản 1991: trình duyệt nhận về một trang mà không biết đó là tài liệu hay lời báo lỗi.
Câu trả lời mở đầu bằng một con số
Câu trả lời ngày nay mở đầu bằng một mã trạng thái (status code): một con số ba chữ số cho biết chuyện gì đã xảy ra. Trình duyệt đọc con số đó trước, chưa cần đọc nội dung.
Yêu cầu GET /hello ở trên nhận về câu trả lời này:
HTTP/1.1 200 OK
Date: Mon, 28 Sep 2026 03:00:00 GMT
Content-Type: text/plain; charset=utf-8
Content-Length: 9

xin chào
Dòng đầu: phiên bản, mã 200, và chữ OK cho người đọc. Vài dòng sau mô tả nội dung: loại gì, dài bao nhiêu byte. xin chào có 8 ký tự nhưng dài 9 byte, vì chữ à cần 2 byte. Sau một dòng trống mới đến nội dung.
Đổi đường dẫn thì chỉ con số ở dòng đầu đổi theo:
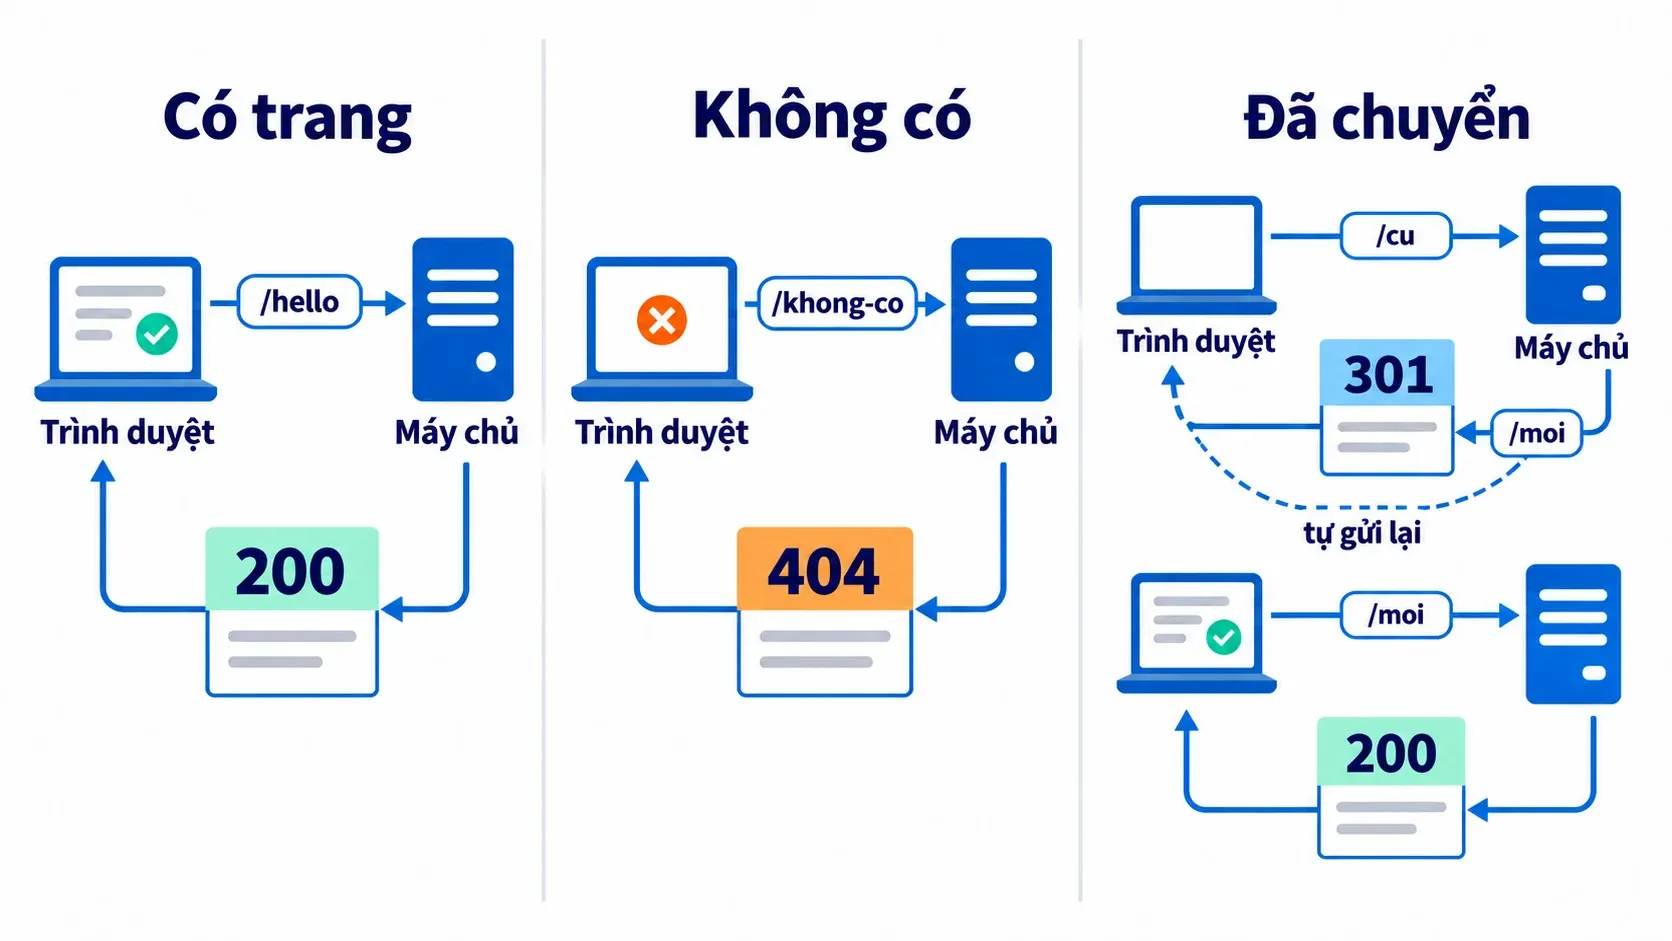
Trang 404 vẫn có nội dung chữ, như năm 1991. Khác ở chỗ trình duyệt không cần đọc nó: con số đã nói là không có.
Mã hay gặp thứ tư là 500: máy chủ nhận được yêu cầu nhưng gặp lỗi khi xử lý.
Mỗi vòng như thế gồm đúng một câu hỏi và một câu trả lời. Xong vòng là xong. Vòng sau không biết gì về vòng trước.
HTTP không nhớ gì cả
Bản 1991 cắt kết nối ngay sau khi gửi xong tài liệu, nên mỗi lần hỏi là một lần riêng. HTTP ngày nay vẫn giữ nguyên tắc đó: máy chủ trả lời xong là quên. Nó không biết người vừa hỏi mình mười giây trước chính là bạn.
Một trang web thường gồm nhiều tệp: HTML, CSS, JavaScript, font, ảnh. Mỗi tệp là một yêu cầu riêng. Với máy chủ, đó là nhiều câu hỏi không liên quan đến nhau.
Vậy làm sao bạn đăng nhập một lần mà các trang sau vẫn nhận ra bạn? Sau khi đăng nhập, máy chủ đưa trình duyệt một mẩu chữ nhỏ gọi là cookie. Từ đó, mọi yêu cầu tới website đó đều tự mang theo cookie. Máy chủ không nhớ bạn, nó chỉ đọc cookie mỗi lần.
HTTP là một cuộc hỏi đáp bằng chữ thường, không trí nhớ: trình duyệt xin một đường dẫn, máy chủ trả về một mã trạng thái kèm nội dung.
Cuộc hỏi đáp đó đi qua router nhà bạn, qua thiết bị của nhà mạng, qua vài mạng trung gian nữa. Yêu cầu POST chứa mật khẩu cũng đi như vậy, bằng chữ thường. HTTP sinh ra để các nhà khoa học chia sẻ tài liệu cho nhau đọc, nên nó không có bước nào để giấu nội dung.
Những chỗ trên đường có đọc được mật khẩu bạn gửi không?