GIN index là gì? Làm sao tìm nhanh một đoạn ký tự bất kỳ trong chuỗi?
Làm sao tìm nhanh những dòng chứa các mẩu ba ký tự?
Ở bài trước, PostgreSQL tách biển số thành các mẩu ba ký tự. Khi tìm '%600.5%', nó cũng lấy ra được những mẩu mà biển số phù hợp phải có.
Nhưng bảng vehicles chỉ cho biết mỗi dòng có biển số nào. Muốn biết mẩu 600 nằm trong những biển số nào, PostgreSQL vẫn phải mở từng biển số ra xem, tức là đọc cả bảng.
Làm sao tìm nhanh những dòng chứa các mẩu ba ký tự?
GIN lưu danh sách dòng cho từng mẩu
Bảng vehicles cho biết mỗi dòng có biển số nào:
| Dòng | Biển số |
|---|---|
| 101 | 47P-600.55 |
| 205 | 51A-600.45 |
| 412 | 29A-600.12 |
Muốn biết mẩu 600 xuất hiện ở đâu, bảng này không có sẵn câu trả lời. PostgreSQL phải xem nội dung từng biển số.
GIN index lưu thêm một cách tra: với mỗi mẩu, nó giữ danh sách các dòng chứa mẩu đó. Mẩu 600 có trong cả ba biển số trên, nên index có một mục:
600 → dòng 101, 205 và 412
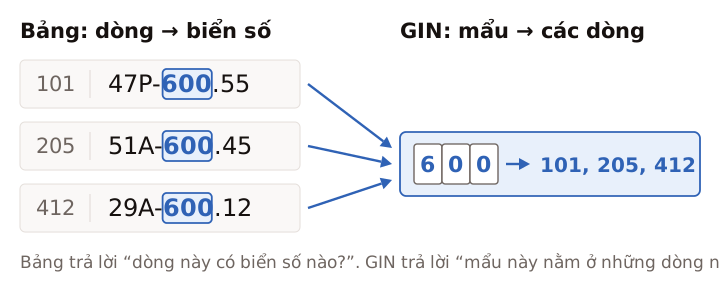
GIN lưu danh sách các dòng chứa mỗi mẩu.
Cách lưu này được gọi là index đảo ngược (inverted index): từ một mẩu, ta tra ngược ra những dòng chứa nó, giống bảng tra cứu cuối sách ghi mỗi thuật ngữ kèm những trang nhắc tới nó. GIN là viết tắt của Generalized Inverted Index.
pg_trgm quyết định cách tạo các mẩu ba ký tự. GIN cung cấp cấu trúc để lưu và tra các mẩu đó.
GIN tìm biển số như thế nào?
Giả sử cần tìm biển số chứa 600.5:
SELECT *
FROM vehicles
WHERE plate LIKE '%600.5%';
Như đã thấy ở bài pg_trgm, PostgreSQL lấy từ mẫu tìm kiếm ba mẩu:
600, 00␣ và ␣␣5. GIN tra ba mẩu này để tìm những dòng cần kiểm tra.
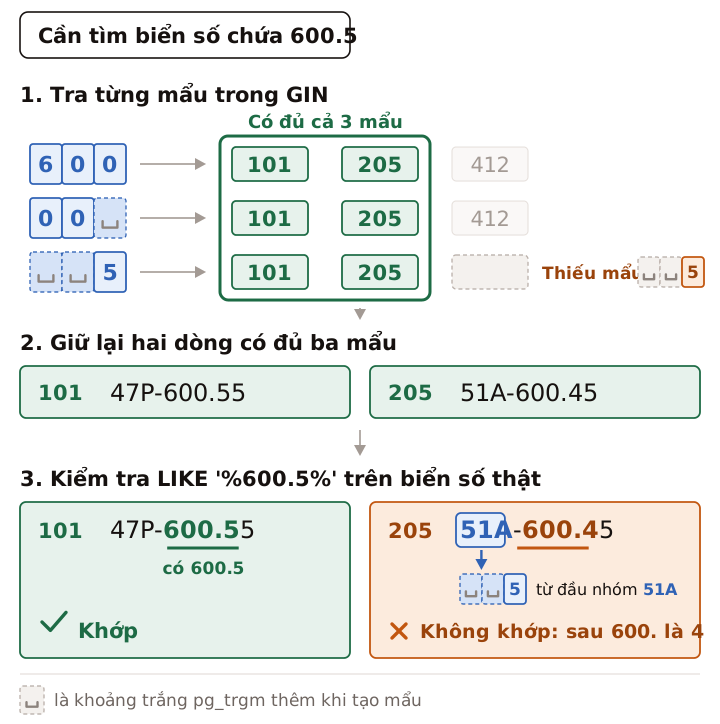
Dòng 205 có đủ ba mẩu nhưng vẫn không khớp: mẩu ␣␣5 đến từ đầu
nhóm 51A, không phải từ phần sau 600..
GIN tìm các dòng có thể khớp; PostgreSQL kiểm tra lại biển số thật để chọn kết quả cuối cùng.
Tạo GIN index cho biển số
Trước tiên cần bật phần mở rộng pg_trgm, nếu cơ sở dữ liệu chưa có:
CREATE EXTENSION IF NOT EXISTS pg_trgm;Sau đó tạo index:
CREATE INDEX vehicles_plate_trgm_idx
ON vehicles USING GIN (plate gin_trgm_ops);
Trong đó:
USING GIN: tạo index theo cấu trúc GIN.plate: cột biển số cần đánh index.gin_trgm_ops: dùng các mẩu ba ký tự củapg_trgmđể tra.
Sau khi có index, PostgreSQL có thể chọn dùng nó cho những câu tìm kiếm phù hợp như LIKE '%600.5%'. Nếu đoạn cần tìm quá ngắn, như '%60%' ở bài trước, không rút ra được mẩu nào thì index cũng không giúp được.
Trên bảng 5 triệu xe của môi trường thực hành, câu LIKE '%600.5%' cho kết quả:
| Không dùng GIN | Dùng GIN | |
|---|---|---|
| Thời gian | khoảng 117 ms | khoảng 2,9 ms |
| Dòng phải kiểm tra biển số | 5.000.000 | 1.008 ứng viên |
| Dòng khớp | 500 | 500 |
Kế hoạch khi dùng GIN, rút gọn:
Bitmap Heap Scan on vehicles (actual rows=500)
  Rows Removed by Index Recheck: 508
  ->  Bitmap Index Scan on vehicles_plate_trgm_idx (actual rows=1008)
Đọc từ dưới lên:
- Bitmap Index Scan: GIN tra ba mẩu và trả về 1.008 ứng viên.
- Bitmap Heap Scan: PostgreSQL đọc các dòng ứng viên, kiểm tra lại
LIKE, loại 508 dòng và giữ 500.
Thời gian phụ thuộc vào máy, dữ liệu và bộ nhớ đệm; các con số trên chỉ mô tả lần đo này.
Đổi lại tốc độ tìm kiếm, GIN tốn thêm gì?
GIN tìm nhanh vì danh sách dòng của từng mẩu đã được chuẩn bị sẵn. Những danh sách này cần chỗ để lưu, và phải được cập nhật khi dữ liệu thay đổi.
Một mẩu có thể có mặt trong rất nhiều biển số. Trên bảng thực hành, mẩu 600 có trong 5.000 biển, còn ␣␣5 có trong khoảng 1,4 triệu biển, vì biển nào có một nhóm bắt đầu bằng 5 cũng có mẩu này. Cả index chỉ có 3.810 mẩu khác nhau, nhưng danh sách dòng của chúng chiếm hơn 90% dung lượng index.
Khi thêm một biển số mới, PostgreSQL lấy các mẩu từ biển số đó và thêm dòng mới vào danh sách của từng mẩu. Biển 47P-600.55 có 11 mẩu, nên thêm một xe là 11 danh sách phải cập nhật:
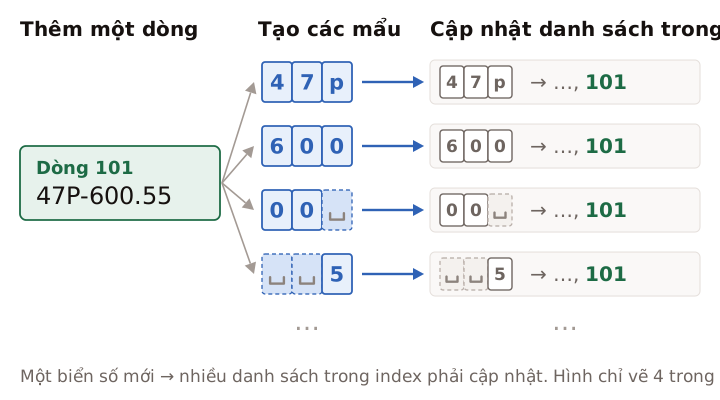
Một biển số mới làm thay đổi nhiều danh sách trong index.
Vì vậy, GIN có hai chi phí chính:
- Dung lượng trên ổ đĩa: index cần thêm chỗ để lưu các danh sách dòng.
- Chi phí ghi: khi thêm xe hoặc sửa biển số, PostgreSQL phải cập nhật thêm index.
Đặt lợi ích và chi phí cạnh nhau, đo trên môi trường thực hành:
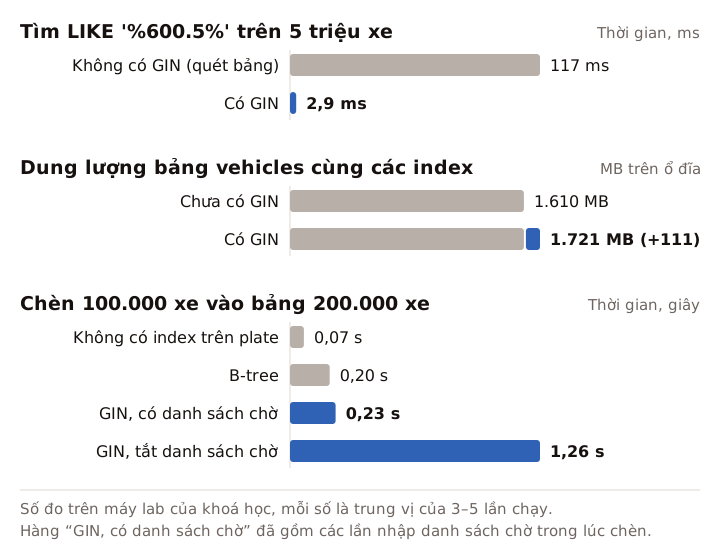
- Câu tìm
'%600.5%'nhanh hơn khoảng 40 lần. - Index GIN chiếm thêm 111 MB trên ổ đĩa, bên cạnh 1.610 MB của bảng và index khoá chính.
- Một lệnh chèn 100.000 xe mất 0,23 giây khi GIN dùng danh sách chờ, và 1,26 giây khi tắt danh sách chờ. Bảng không có index trên
platechỉ mất 0,07 giây.
GIN có thể giảm thời gian tìm kiếm, nhưng cần thêm dung lượng và công việc cập nhật index. Mức chênh lệch phụ thuộc vào dữ liệu và cách ứng dụng đọc, ghi.
Danh sách chờ giúp ghi nhanh hơn như thế nào?
Nếu mỗi lần thêm xe đều phải chen ngay vào cả chục danh sách trong index chính, việc ghi sẽ chậm, như hàng cuối của biểu đồ trên.
Vì vậy, GIN có danh sách chờ (pending list), bật sẵn qua tuỳ chọn fastupdate. Thông tin mới được ghi nối vào một vùng tạm, chưa sắp xếp. Sau đó, PostgreSQL chuyển cả danh sách chờ vào index chính theo đợt: khi danh sách vượt ngưỡng gin_pending_list_limit (mặc định 4 MB), khi bảng được vacuum hoặc autoanalyze, hoặc khi gọi hàm gin_clean_pending_list.
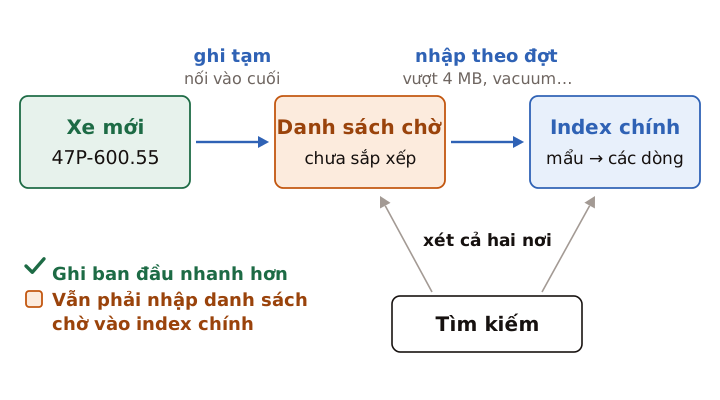
Danh sách chờ gom việc cập nhật index chính thành từng đợt.
Nhập theo đợt rẻ hơn chèn từng mục, vì nhiều dòng mới có chung một mẩu được thêm vào danh sách của mẩu đó trong một lượt. Trong phép đo ở trên, con số 0,23 giây đã gồm các lần nhập diễn ra trong lúc chèn. Phần còn lại trong danh sách chờ sau lệnh chèn chỉ mất thêm khoảng 3 ms để dọn.
Nhưng danh sách chờ vẫn phải được xử lý:
- Khi tìm kiếm, PostgreSQL phải xét cả index chính lẫn danh sách chờ. Danh sách chờ càng dài, tìm càng chậm.
- Lệnh ghi làm danh sách chờ vượt ngưỡng phải tự dọn cả danh sách, nên chậm hơn hẳn những lệnh ghi khác.
Danh sách chờ gom việc ghi lại thành đợt; nó không làm việc cập nhật index biến mất.
Có thể tắt danh sách chờ bằng fastupdate = off nếu muốn tránh những lần dọn đột xuất. Đổi lại, mỗi lần ghi phải cập nhật index chính ngay. Cần đo trên tải thực tế trước khi quyết định:
CREATE INDEX vehicles_plate_trgm_idx
ON vehicles USING GIN (plate gin_trgm_ops)
WITH (fastupdate = off);
GIN không chỉ dùng cho biển số
Xét một bảng sản phẩm, mỗi sản phẩm có nhiều thẻ:
| Sản phẩm | Thẻ |
|---|---|
| Máy ảnh A | du lịch, nhỏ gọn |
| Máy ảnh B | du lịch, chuyên nghiệp |
| Máy ảnh C | nhỏ gọn |
Nếu cần tìm sản phẩm có thẻ du lịch, GIN có thể tra từ thẻ đó ra những dòng chứa nó:
du lịch → máy ảnh A, máy ảnh B
Ý tưởng vẫn giống ví dụ biển số: từ một phần của dữ liệu, tìm ra những dòng có phần đó. PostgreSQL còn hỗ trợ GIN cho mảng, jsonb và tìm kiếm toàn văn. Thứ gì được đưa vào index và phép tìm nào dùng được phụ thuộc vào cách cấu hình index.
Có GIN rồi, PostgreSQL có luôn dùng không?
Trong ví dụ trên, GIN thu hẹp 5 triệu xe xuống 1.008 ứng viên. Nhưng nếu đoạn cần tìm xuất hiện trong phần lớn biển số, PostgreSQL vẫn phải đọc rất nhiều dòng dù đã dùng index.
Khi đó, đọc tuần tự cả bảng đôi khi lại ít tốn công hơn.
PostgreSQL dựa vào đâu để quyết định dùng index hay quét bảng?
Nguồn bài viết (5)
- 65.4.1. Introduction (GIN Indexes) · PostgreSQL 18 Documentation
- 65.4.4. Implementation (GIN Indexes) · PostgreSQL 18 Documentation
- 65.4.4.1. GIN Fast Update Technique · PostgreSQL 18 Documentation
- gin_pending_list_limit (19.11. Client Connection Defaults) · PostgreSQL 18 Documentation
- F.35. pg_trgm — support for similarity of text using trigram matching · PostgreSQL 18 Documentation