Vì sao LIKE không dùng index?
Vì sao đã có index mà LIKE vẫn quét cả bảng?
Bảng vehicles có 5 triệu xe. Cột plate lưu biển số và đã có index B-tree:
CREATE INDEX vehicles_plate_idx ON vehicles (plate);Khi biết chính xác biển số, PostgreSQL có thể tìm bằng index:
SELECT *
FROM vehicles
WHERE plate = '47P-600.55';
Nhưng khi tìm các biển số bắt đầu bằng 47P-600, PostgreSQL lại quét cả bảng:
SELECT *
FROM vehicles
WHERE plate LIKE '47P-600%';
Trong môi trường thực hành, câu truy vấn này tìm được 2 xe nhưng phải đọc toàn bộ 192.308 page của bảng.
Vì sao đã có index mà LIKE vẫn quét cả bảng?
Tìm theo phần đầu bằng B-tree
Dấu % trong câu truy vấn có nghĩa là sau 47P-600 có thể là bất kỳ chuỗi ký tự nào.
Vì vậy, cả hai biển số dưới đây đều khớp:
47P-600.00
47P-600.55
Nếu các biển số được sắp xếp như hình sau, PostgreSQL có thể tìm chúng trong một đoạn liên tiếp:
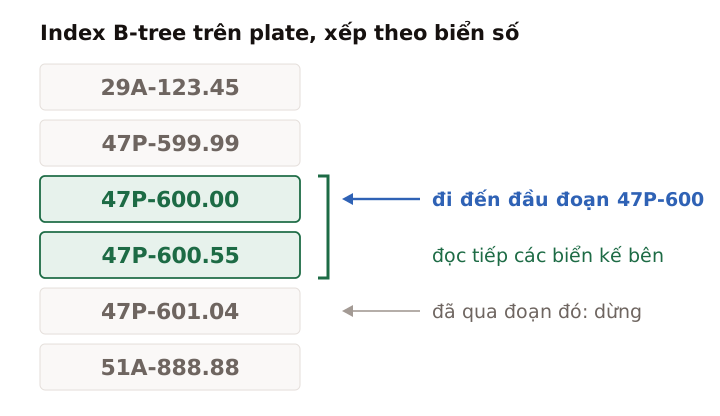
Các ô màu là những biển số bắt đầu bằng 47P-600.
PostgreSQL có thể đi đến đầu đoạn 47P-600, đọc các biển số tiếp theo, rồi dừng khi đi qua đoạn đó. Các phần còn lại của index không cần đọc.
Đó là lý do B-tree có thể giúp tìm theo phần đầu. Nhưng để áp dụng cách này, PostgreSQL cần xác định được đoạn cần đọc trong index.
Điều đó phụ thuộc vào cách index sắp xếp chuỗi.
Cách sắp xếp ảnh hưởng gì đến LIKE?
Khi làm việc với chuỗi, có nhiều cách quyết định thứ tự. Ví dụ, một cách sắp xếp có thể xét chữ hoa, chữ thường và dấu trên chữ cái khác với cách so sánh từng ký tự.
Hãy xem một ví dụ đơn giản. Giả sử một quy tắc sắp xếp đưa chữ a và A lại gần nhau:
| Thứ tự trong ví dụ | Chuỗi | Khớp LIKE 'ab%'? |
|---|---|---|
| 1 | ab1 |
Có |
| 2 | aB2 |
Không |
| 3 | ab3 |
Có |
Trong ví dụ này, hai chuỗi bắt đầu đúng bằng ab bị một chuỗi khác xen vào giữa.
Đây là một cách sắp xếp giả định để giải thích vấn đề, không phải thứ tự được khẳng định cho dữ liệu biển số của bài thực hành.
Điểm cần thấy là: cách sắp xếp phục vụ ngôn ngữ không nhất thiết giống cách nhóm các chuỗi theo đúng phần đầu ký tự.
Bộ quy tắc mà PostgreSQL dùng để so sánh và sắp xếp chuỗi được gọi là collation. Trong môi trường thực hành, cột plate dùng quy tắc có tên en_US.utf8, và index B-tree thông thường cũng được sắp xếp theo quy tắc đó.
Với index này, PostgreSQL không tạo khoảng tìm kiếm cho điều kiện LIKE '47P-600%'. Trong phép đo của bài, nó chọn quét bảng.
Muốn tìm nhanh theo phần đầu, PostgreSQL cần một index có thứ tự phù hợp để xác định khoảng cần đọc.
Tạo index cho tìm kiếm theo phần đầu
Ta có thể tạo thêm một index B-tree với text_pattern_ops:
CREATE INDEX vehicles_plate_pattern_idx
ON vehicles (plate text_pattern_ops);
text_pattern_ops yêu cầu index so sánh chuỗi theo từng ký tự. Với cách sắp xếp này, PostgreSQL có thể xác định khoảng chứa các chuỗi bắt đầu bằng 47P-600.
Hình dưới đây cho thấy sự khác biệt đối với câu truy vấn của chúng ta:
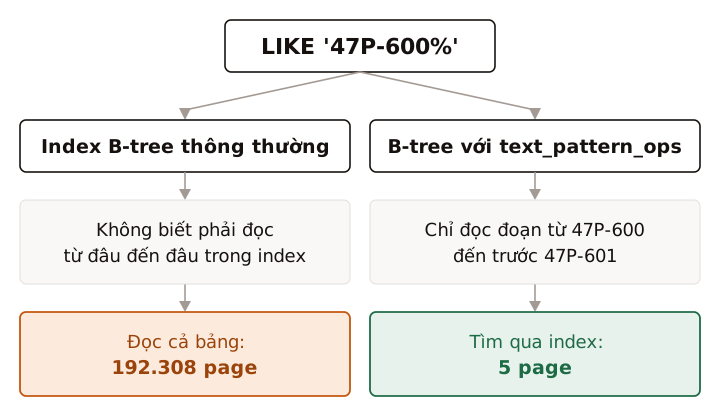
Cùng một câu LIKE; index mới cho PostgreSQL thêm một cách tìm.
Câu truy vấn vẫn giữ nguyên:
SELECT *
FROM vehicles
WHERE plate LIKE '47P-600%';
Trong môi trường thực hành, sau khi tạo index mới, kế hoạch có dạng:
Index Scan using vehicles_plate_pattern_idx on vehicles
  Index Cond: ((plate ~>=~ '47P-600') AND (plate ~<~ '47P-601'))
  Filter: (plate ~~ '47P-600%')
Có thể đọc kế hoạch này theo hai bước:
Index Cond: tìm trong khoảng từ47P-600đến trước47P-601.Filter: kiểm tra lại điều kiệnLIKEtrên các dòng tìm được.
Nếu cột plate là varchar, có thể dùng varchar_pattern_ops:
CREATE INDEX vehicles_plate_pattern_idx
ON vehicles (plate varchar_pattern_ops);
Có thể xoá index cũ không?
Chưa nên xoá ngay. Index mới hỗ trợ tìm theo phần đầu và có thể hỗ trợ tìm chính xác bằng =. Nhưng ứng dụng có thể còn dùng index cũ cho các phép so sánh như <, > theo quy tắc sắp xếp của cột.
Giữ thêm index cũng có giá của nó: tốn dung lượng và PostgreSQL phải cập nhật index khi dữ liệu thay đổi. Hãy xem những truy vấn khác trên cột plate trước khi quyết định có giữ cả hai hay không.
Làm sao biết PostgreSQL có dùng index?
Dùng EXPLAIN (ANALYZE, BUFFERS) để xem kế hoạch thực tế:
EXPLAIN (ANALYZE, BUFFERS)
SELECT *
FROM vehicles
WHERE plate LIKE '47P-600%';
Nếu thấy Index Scan dùng vehicles_plate_pattern_idx, PostgreSQL đã chọn tìm qua index mới.
Tuy nhiên, có index phù hợp không có nghĩa là PostgreSQL luôn dùng nó. Nếu điều kiện khớp với phần lớn bảng, PostgreSQL có thể ước tính rằng quét bảng sẽ ít tốn công hơn.
Nếu chỉ nhớ một đoạn giữa biển số?
Với câu truy vấn vừa rồi, ta biết biển số bắt đầu bằng 47P-600:
WHERE plate LIKE '47P-600%'Thông tin đó cho PostgreSQL biết cần bắt đầu tìm ở đâu trong index phù hợp.
Nhưng người dùng không phải lúc nào cũng nhớ phần đầu. Họ có thể chỉ nhớ 600.5 và tìm bằng:
WHERE plate LIKE '%600.5%'Dấu % ở đầu cho phép biển số có bất kỳ ký tự nào trước 600.5. Vì vậy, cả ba biển số sau đều có thể khớp:
29A-600.5047P-600.5551A-600.59
Vấn đề là B-tree sắp xếp cả biển số từ phần đầu. Ba biển số trên bắt đầu bằng 29A, 47P và 51A, nên chúng có thể nằm ở những vùng khác nhau:
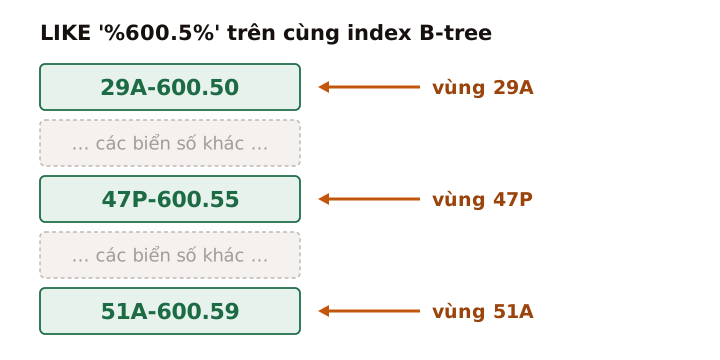
Các biển số chứa 600.5 nằm ở nhiều nơi vì phần đầu của chúng khác nhau.
Khi chỉ biết 600.5, PostgreSQL không biết phải đi đến vùng 29A, 47P, 51A hay một vùng nào khác. Đổi sang text_pattern_ops cũng không giải quyết được: index mới vẫn sắp xếp biển số theo thứ tự từ đầu chuỗi.
| Câu tìm kiếm | Phần đã biết | B-tree phù hợp có thể làm gì? |
|---|---|---|
LIKE '47P-600%' |
Biết phần đầu | Đi đến khoảng chứa các chuỗi có phần đầu đó |
LIKE '%600.5%' |
Chỉ biết một đoạn bên trong | Không xác định được một khoảng theo phần đầu |
Làm sao tìm một đoạn ở giữa chuỗi mà không phải quét cả bảng?
Nguồn bài viết (3)
- 11.2. Index Types · PostgreSQL 18 Documentation
- 11.10. Operator Classes and Operator Families · PostgreSQL 18 Documentation
- 14.1. Using EXPLAIN · PostgreSQL 18 Documentation