Vì sao PostgreSQL không dùng index dù đã có index?
Cùng một index, vì sao tìm tỉnh này dùng index còn tỉnh khác lại quét bảng?
Bảng vehicles có index trên cột province. Hai câu SQL dưới đây chỉ khác tên tỉnh:
SELECT *
FROM vehicles
WHERE province = 'Lai Châu';
SELECT *
FROM vehicles
WHERE province = 'TP.HCM';Trong bộ dữ liệu thực hành, PostgreSQL dùng index để tìm xe ở Lai Châu, nhưng lại quét bảng khi tìm xe ở TP.HCM.
Cùng một index, vì sao tìm tỉnh này dùng index còn tỉnh khác lại quét bảng?
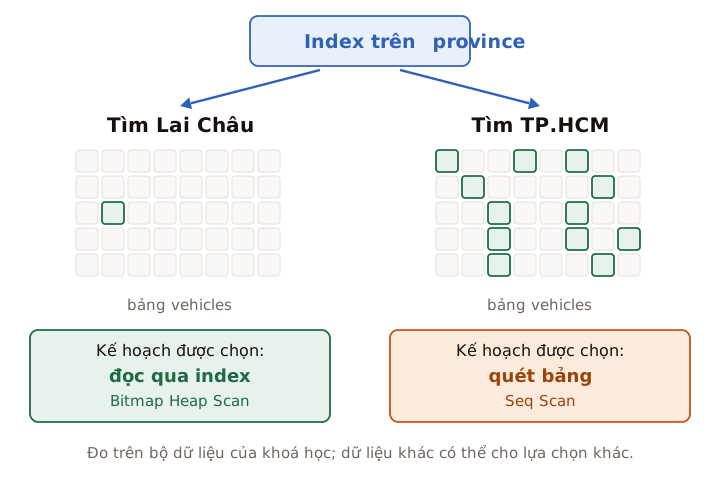
Hai câu truy vấn chỉ khác giá trị tìm kiếm, nhưng có thể có kế hoạch khác nhau.
Tìm ít xe và tìm nhiều xe
Bảng có 5 triệu xe. Trong đó:
| Tỉnh | Số xe | Tỷ lệ trong bảng |
|---|---|---|
| Lai Châu | 24.912 | Khoảng 0,5% |
| TP.HCM | 1.502.448 | Khoảng 30% |
Với Lai Châu, PostgreSQL chỉ cần tìm một phần nhỏ dữ liệu. Đi qua index giúp nó bỏ qua phần lớn bảng không cần đọc.
Với TP.HCM, câu truy vấn cần lấy hơn 1,5 triệu xe. PostgreSQL vẫn có thể tìm chúng qua index, nhưng còn phải đọc dữ liệu của từng xe trong bảng. Lúc này, quét bảng có thể được ước lượng là ít tốn công hơn.
Để hiểu vì sao, cần nhìn vào nơi dữ liệu được lưu.
Dùng index vẫn phải đọc bảng
Index trên province giúp PostgreSQL tìm vị trí của các dòng có tỉnh cần tìm. Nhưng câu SQL dùng SELECT *, nên PostgreSQL cần lấy cả những cột khác của xe từ bảng.
Dữ liệu trong bảng được lưu theo từng page. Một page có thể chứa nhiều dòng.
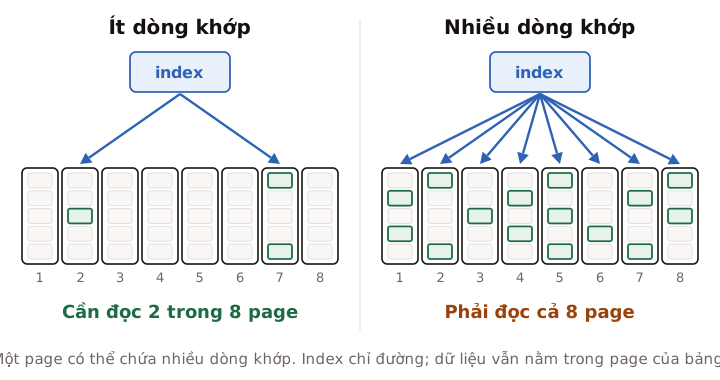
Số page phải đọc phụ thuộc vào chỗ các dòng khớp nằm, không chỉ vào số dòng khớp.
Trong bảng thực hành:
| Tỉnh | Số dòng khớp | Số page chứa dòng khớp |
|---|---|---|
| Lai Châu | 24.912 | 23.402 |
| TP.HCM | 1.502.448 | 192.284 |
Toàn bảng có 192.308 page. Xe ở Lai Châu nằm trên khoảng 12% số page, còn xe ở TP.HCM có mặt trên gần như mọi page.
Nếu tìm xe ở TP.HCM qua index, PostgreSQL vẫn phải đọc gần hết bảng để lấy dữ liệu, lại thêm phần việc tra index. Đọc thẳng cả bảng từ đầu đến cuối khi đó trở thành lựa chọn đáng cân nhắc.
Index giúp tìm vị trí dòng, nhưng không bỏ được việc đọc dữ liệu từ bảng.
Số dòng khớp không phải yếu tố duy nhất. Vị trí các dòng trong bảng, những cột cần lấy và cấu hình cost cũng ảnh hưởng đến lựa chọn của planner.
PostgreSQL có những cách đọc nào?
Với hai câu truy vấn trên, planner có thể cân nhắc ba cách đọc đã gặp ở những bài trước:
| Cách đọc | Cách làm |
|---|---|
| Index Scan | Đi qua index để tìm các dòng khớp, rồi đọc dữ liệu tương ứng từ bảng. |
| Bitmap Heap Scan | Đi qua index, gom vị trí các dòng cần tìm, rồi đọc các page tương ứng của bảng. |
| Seq Scan | Đọc lần lượt các page của bảng và kiểm tra điều kiện trên từng dòng. |
Hai cách dùng index khác nhau ở cách chúng đi vào bảng. Index Scan có thể phải nhảy qua lại giữa các page khi lần theo index. Bitmap Heap Scan gom các vị trí lại trước, rồi đọc các page theo thứ tự vật lý.
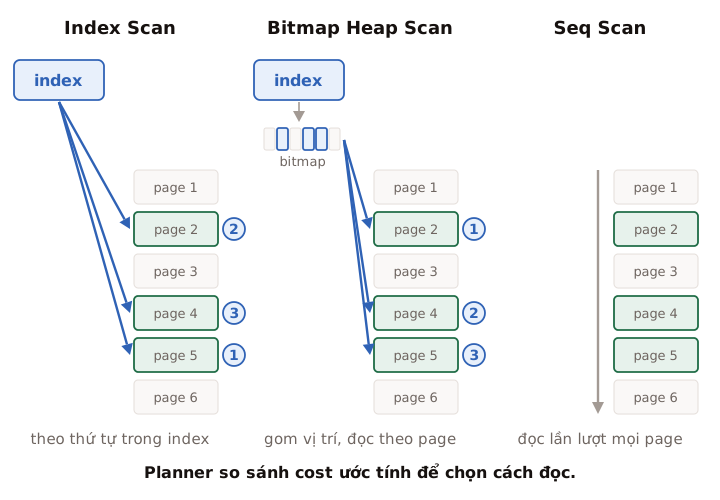
Bitmap Heap Scan gom các vị trí cần đọc trước khi đi vào bảng.
Tạm tắt từng cách đọc để planner in ra cost của những cách còn lại, ta có cost ước tính của cả ba:
| Cách đọc | Lai Châu | TP.HCM |
|---|---|---|
| Index Scan | 90.605 | 780.313 |
| Bitmap Heap Scan | 69.167 | 264.212 |
| Seq Scan | 221.816 | 254.808 |
Số in đậm là cách planner chọn: với Lai Châu là Bitmap Heap Scan, với TP.HCM là Seq Scan. Tắt cách đọc chỉ là mẹo để so sánh trong môi trường thực hành, không phải việc nên làm trong ứng dụng.
Nhưng trước khi chạy câu SQL, planner chưa biết chính xác có bao nhiêu xe ở mỗi tỉnh. Vậy những con số nó dùng để tính cost đến từ đâu?
Planner ước lượng số dòng khớp như thế nào?
Planner không đếm lại cả bảng mỗi khi nhận một câu SQL. Nó dùng thống kê mà PostgreSQL đã thu thập từ trước.
Lệnh ANALYZE lấy mẫu dữ liệu và cập nhật thống kê cho bảng. Với bảng lớn, PostgreSQL chỉ đọc một mẫu thay vì từng dòng, nên kết quả là số ước lượng.
Trong môi trường thực hành, thống kê cho biết:
- Khoảng 0,49% số xe thuộc Lai Châu.
- Khoảng 30,14% số xe thuộc TP.HCM.
Nhân các tỷ lệ này với số dòng ước tính của bảng, planner ra số dòng dự kiến khớp:
| Tỉnh | Planner ước tính | Thực tế |
|---|---|---|
| Lai Châu | 24.667 | 24.912 |
| TP.HCM | 1.507.002 | 1.502.448 |
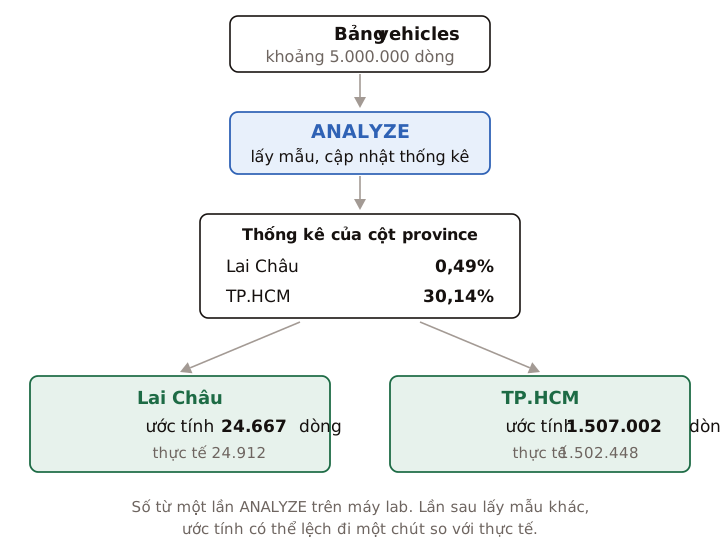
Planner dự đoán số dòng từ thống kê đã thu thập.
Với hai câu này, số ước tính khá sát thực tế. PostgreSQL thường tự chạy ANALYZE qua autovacuum, nhưng cũng có thể chạy thủ công:
ANALYZE vehicles;Dữ liệu có thể thay đổi sau lần thu thập gần nhất, nên thống kê không phải lúc nào cũng phản ánh đúng bảng hiện tại.
Xem thống kê ở đâu?
Thống kê của cột province nằm trong view pg_stats:
SELECT
  most_common_vals,
  most_common_freqs
FROM pg_stats
WHERE tablename = 'vehicles'
  AND attname = 'province';
Kết quả rút gọn trong môi trường thực hành:
most_common_vals  | {TP.HCM,"Hà Nội",…,"Lai Châu"}
most_common_freqs | {0.3014,0.25223333,…,0.0049333335}
Hai danh sách đi theo cùng thứ tự. TP.HCM là giá trị đầu tiên trong most_common_vals, nên 0.3014 ở đầu most_common_freqs là tỷ lệ ước tính của nó.
Bảng thực hành chỉ có 13 tỉnh và cả 13 đều có trong danh sách. Sau mỗi lần ANALYZE, tỷ lệ có thể lệch đi một chút vì PostgreSQL lấy một mẫu khác.
Thử thay đổi số dòng khớp
Không chỉ tên tỉnh mới làm số dòng khớp thay đổi. Giá xe trong bảng trải đều từ 200 triệu tới 2 tỷ, nên đổi mức giá tối đa là đổi được số xe khớp:
SELECT *
FROM vehicles
WHERE price_vnd < 218000000;
Kéo thanh bên dưới để đổi mức giá và xem planner chọn cách đọc nào:
SELECT * FROM vehicles WHERE price_vnd < 218000000; 48.302 xe khớp · 0,97% bảng
Planner chọn Bitmap Heap Scan · cost 109.769
Cost của Bitmap Heap Scan và Bitmap Heap Scan chênh nhau dưới 1%: planner coi như bằng nhau và chọn Bitmap Heap Scan.
Trục tỷ lệ được giãn để dễ quan sát các mức thấp.
- Seq ScanĐược chọn 254.808
- Index ScanĐược chọn 168.016
- Bitmap Heap ScanĐược chọn 109.769
Xem thời gian đo thực tế
Thời gian đo trong lab: Bitmap 51 ms · Index 81 ms · Seq Scan 306 ms
Planner chọn theo cost ước tính; thời gian thực tế được đo sau khi chạy.
Khi số dòng cần lấy thay đổi, cách đọc có cost thấp nhất cũng có thể thay đổi.
Trong dải đang hiển thị, planner không chọn Index Scan cho câu SELECT * này. Giá xe rải ngẫu nhiên trong bảng, nên ngay cả khi ít xe khớp, gom vị trí theo page như Bitmap Heap Scan vẫn rẻ hơn.
Ở khoảng 5–15%, cost của Bitmap Heap Scan và Seq Scan gần như bằng nhau. Khi hai cost chênh nhau dưới 1%, planner coi chúng là bằng nhau và chọn Seq Scan, cách bắt đầu trả dòng sớm hơn. Vì vậy lựa chọn có thể đổi qua đổi lại trong khoảng này.
Kết quả phụ thuộc vào dữ liệu, câu SQL và cấu hình của môi trường thực hành. Không có một tỷ lệ chung áp dụng cho mọi bảng.
Nếu planner ước lượng sai thì sao?
Planner chọn kế hoạch dựa trên những gì nó ước lượng. Nếu số dòng dự đoán lệch nhiều so với thực tế, cost cũng lệch theo và planner có thể chọn một kế hoạch không tốt.
Để kiểm tra, dùng EXPLAIN ANALYZE:
EXPLAIN ANALYZE
SELECT *
FROM vehicles
WHERE province = 'Lai Châu';
Dòng đầu của kết quả trong môi trường thực hành:
Bitmap Heap Scan on vehicles
  (cost=279.60..69167.29 rows=24667 width=267)
(actual time=2.624..60.112 rows=24912.00 loops=1)rows=24667: planner ước tính bước này trả về 24.667 dòng.actual … rows=24912.00: thực tế bước này trả về 24.912 dòng. Khiloopslớn hơn 1, đây là số dòng trung bình mỗi lần bước đó chạy.
Hai số ở đây khá gần nhau. Nếu chúng lệch nhau hàng chục hoặc hàng trăm lần, nên kiểm tra lại thống kê. Thống kê cũ là một khả năng; ước lượng cũng có thể sai vì lý do khác, chẳng hạn khi giá trị của hai cột phụ thuộc vào nhau.
EXPLAIN ANALYZE chạy thật câu SQL. Với SELECT thì không sao, nhưng với INSERT, UPDATE hay DELETE, dữ liệu sẽ thay đổi thật.
Chỉ tạo index cho phần dữ liệu cần dùng?
Trang “xe đang bán” chỉ cần những xe chưa bán. Nhưng một index thông thường trên cả bảng vẫn chứa các dòng của xe đã bán.
Làm thế nào để tạo index cho một phần của bảng?
Nguồn bài viết (6)
- 14.2. Statistics Used by the Planner · PostgreSQL 18 Documentation
- 14.1. Using EXPLAIN · PostgreSQL 18 Documentation
- EXPLAIN · PostgreSQL 18 Documentation
- 11.5. Combining Multiple Indexes · PostgreSQL 18 Documentation
- 24.1. Routine Vacuuming · PostgreSQL 18 Documentation
- 19.7. Query Planning · PostgreSQL 18 Documentation