Index nhiều cột (composite index) hoạt động như thế nào?
Vì sao đổi thứ tự hai cột trong index lại đổi tốc độ truy vấn?
Một trang rao bán ô tô có hàng triệu chiếc xe. Bạn muốn đếm xem có bao nhiêu xe ở Đà Nẵng được đăng từ ngày 1/1/2025.
SELECT count(*) FROM vehicles
WHERE province = 'Đà Nẵng'
  AND listed_at >= '2025-01-01';
PostgreSQL cần tìm những xe thỏa cả hai điều kiện: đúng tỉnh và đủ mới. Nếu không có index phù hợp, nó có thể phải xem rất nhiều dòng trong bảng.
Ta tạo một index chứa cả hai cột. Nhưng nên để province trước hay listed_at trước?
Hai cột trong index được sắp xếp ra sao?
CREATE INDEX idx_vehicles_province_date
ON vehicles (province, listed_at DESC);
Đây là index nhiều cột (composite index), mặc định dùng B-tree trong PostgreSQL. Nó không phải hai index riêng biệt. Mỗi mục index chứa cặp giá trị (province, listed_at) và thông tin để xác định dòng tương ứng trong bảng.
Vì province đứng đầu, PostgreSQL sắp xếp các mục theo tỉnh trước. Trong cùng một tỉnh, nó mới sắp xếp theo ngày đăng, từ mới đến cũ (DESC).
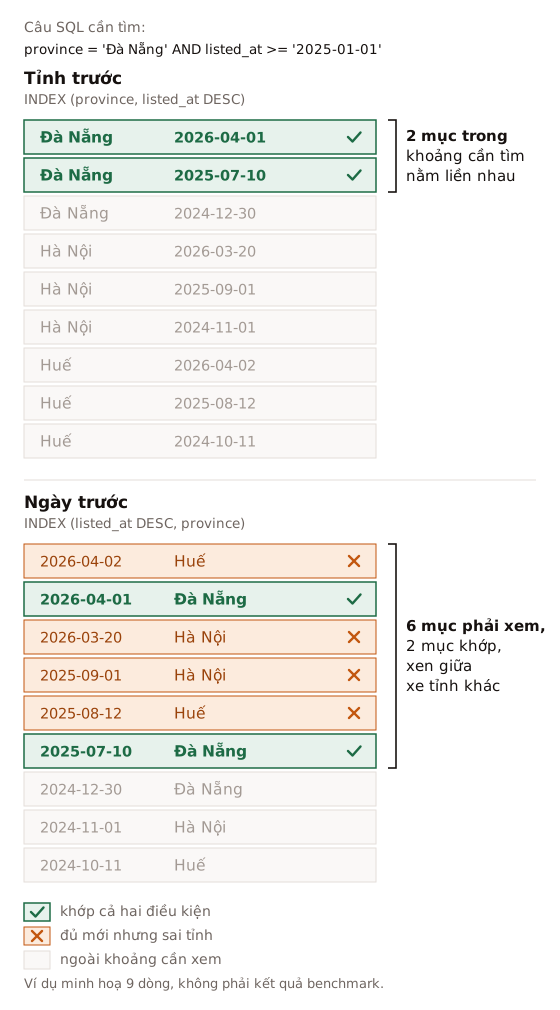
Ví dụ, phần dành cho Đà Nẵng có thể có thứ tự:
Đà Nẵng    2026-04-01  ✓
Đà Nẵng    2025-07-10  ✓
Đà Nẵng    2024-12-30
Để trả lời câu SQL, PostgreSQL dùng B-tree tìm đến phần dành cho Đà Nẵng. Nó chỉ cần xét đoạn có ngày đăng từ năm 2025 trở đi. Xe năm 2024 nằm ngoài đoạn đó; các tỉnh khác cũng vậy.
Hai điều kiện đã thu hẹp tìm kiếm thành một đoạn liên tiếp trong index. PostgreSQL không phải đi từ mục đầu tiên của index để dò từng tỉnh: cấu trúc B-tree giúp nó đi thẳng đến đoạn cần tìm.
Nếu đưa ngày đăng lên trước thì sao?
CREATE INDEX idx_vehicles_date_province
ON vehicles (listed_at DESC, province);
Lần này, tất cả xe được xếp theo ngày trước. Tỉnh chỉ dùng để phân thứ tự khi các xe có cùng thời điểm đăng.
Vì thế, đoạn từ năm 2025 trở đi trông giống thế này:
2026-04-02    Huế       ×
2026-04-01    Đà Nẵng   ✓
2026-03-20    Hà Nội    ×
2025-09-01    Hà Nội    ×
2025-08-12    Huế       ×
2025-07-10    Đà Nẵng   ✓
PostgreSQL vẫn tìm được phần index có ngày đăng từ năm 2025. Nhưng trong phần đó, xe Đà Nẵng nằm xen giữa xe các tỉnh khác. Nó phải xem cả sáu mục để chọn ra hai mục đúng tỉnh.
Với bộ dữ liệu nhỏ trong ví dụ, index tỉnh trước có đoạn cần tìm gồm hai mục; index ngày trước có sáu mục cần xem. Kết quả SQL vẫn như nhau, chỉ khác lượng dữ liệu phải kiểm tra.
Vì sao đọc nhiều mục hơn có thể chậm hơn?
Index B-tree không nằm trong một danh sách dài duy nhất. Nó được chia thành các page. Các page lá chứa những mục index đã sắp thứ tự. Sau khi tìm được vị trí bắt đầu trong cây, PostgreSQL đọc những mục thuộc khoảng cần tìm ở các page lá.
Nếu các mục phù hợp nằm sát nhau, khoảng cần đọc thường ngắn và có thể nằm trên ít page. Nếu chúng bị xen kẽ với rất nhiều mục không phù hợp, PostgreSQL phải đi qua một khoảng lớn hơn, có thể đọc nhiều page hơn.
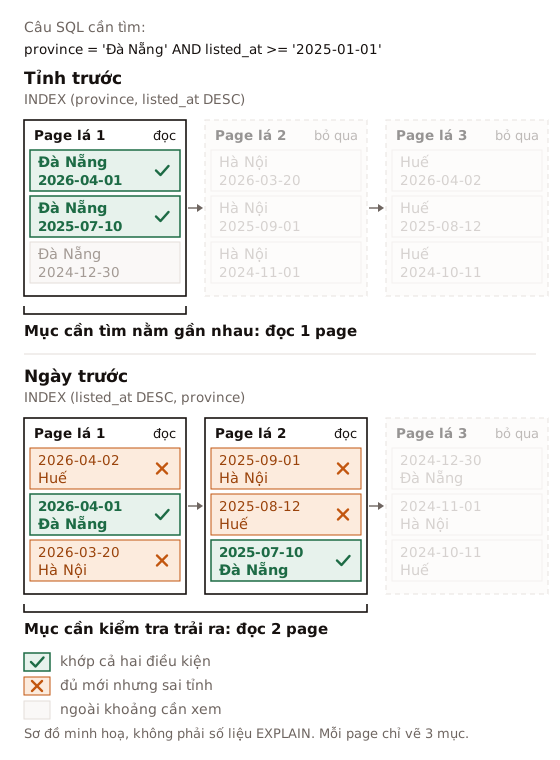
Đó là lý do hai index chứa cùng hai cột vẫn có thể cho tốc độ khác nhau đáng kể. Con số page thực tế phụ thuộc dữ liệu và cách PostgreSQL thực thi câu SQL, không có tỷ lệ nhanh hơn cố định.
Vậy nên đặt cột nào trước?
Không có thứ tự nào tốt nhất cho mọi trường hợp. Nó phụ thuộc vào cách ứng dụng tìm kiếm dữ liệu.
Giả sử trang rao xe có hai chức năng.
Chức năng thứ nhất: tìm xe theo tỉnh và ngày đăng.
SELECT count(*) FROM vehicles
WHERE province = 'Đà Nẵng'
  AND listed_at >= '2025-01-01';
Với câu SQL này, index (province, listed_at DESC) phù hợp hơn. PostgreSQL có thể tìm đến nhóm xe Đà Nẵng, sau đó chỉ đọc khoảng ngày cần thiết.
Chức năng thứ hai: xem những chiếc xe mới đăng trên toàn quốc.
SELECT * FROM vehicles
WHERE listed_at >= '2025-01-01'
ORDER BY listed_at DESC
LIMIT 20;
Lúc này, index (listed_at DESC, province) lại có lợi thế. PostgreSQL có thể bắt đầu từ những xe mới nhất mà không cần tìm qua từng nhóm tỉnh.
Ngược lại, nếu vẫn dùng index đặt province trước, các xe được chia thành từng nhóm tỉnh. Những chiếc xe mới nhất trên toàn quốc không nằm trong một đoạn liên tiếp của index.
Vậy lựa chọn nào tốt hơn?
Nếu phần lớn người dùng tìm xe theo tỉnh, đặt province trước thường hợp lý. Nếu ứng dụng chủ yếu hiển thị xe mới đăng trên toàn quốc, đặt listed_at trước có thể hữu ích hơn.
Bạn cũng có thể tạo cả hai index để phục vụ hai kiểu truy vấn. Nhưng mỗi index đều chiếm dung lượng lưu trữ và cần được cập nhật khi dữ liệu thay đổi. Càng nhiều index, thao tác ghi dữ liệu càng có thể tốn thêm chi phí.
Vì vậy, thiết kế index là một sự đánh đổi giữa tốc độ đọc, tốc độ ghi và dung lượng lưu trữ. Không chỉ nhìn vào một câu SQL, mà cần xem những truy vấn nào được sử dụng nhiều nhất và chúng thực sự đọc bao nhiêu dữ liệu.
Có một điểm khác giữa hai index mà chúng ta chưa xét đến: thứ tự dữ liệu.
Nếu người dùng muốn xem 20 xe Đà Nẵng mới đăng gần đây nhất, liệu PostgreSQL có thể tận dụng thứ tự sẵn có trong index để lấy ngay kết quả mà không phải sắp xếp lại?
Index giúp bỏ bước sắp xếp như thế nào?
Nguồn bài viết (2)
- 11.3. Multicolumn Indexes · PostgreSQL 18 Documentation
- 11.9. Index-Only Scans and Covering Indexes · PostgreSQL 18 Documentation