Index giúp ORDER BY và LIMIT nhanh hơn thế nào?
Vì sao index giúp lấy 20 xe mới nhất mà không cần Sort?
Bạn mở trang tìm xe, chọn Đà Nẵng và bấm Mới nhất. Trang chỉ cần hiện 20 xe đầu tiên, không phải tất cả xe đang bán ở Đà Nẵng.
SELECT id, listed_at FROM vehicles
WHERE province = 'Đà Nẵng' AND listed_at >= '2025-01-01'
ORDER BY listed_at DESC LIMIT 20;
Câu SQL này yêu cầu PostgreSQL: chọn xe Đà Nẵng đăng từ năm 2025, đưa xe mới đăng lên trước, rồi lấy 20 chiếc. Nếu phải xem hàng chục nghìn xe mới chọn ra 20 chiếc, trang sẽ chậm.
Có cách nào lấy ngay 20 chiếc đầu mà không cần xem hết không?
Index giống một danh sách đã được xếp sẵn
Giả sử ta có một danh sách xe, chia theo tỉnh. Trong mỗi tỉnh, xe đăng gần đây nhất nằm trên cùng:
Tỉnh          Ngày đăng
────────────────────────────
Cần Thơ       28/10/2026
Cần Thơ       25/10/2026
    ...
Đà Nẵng       29/10/2026   ← xe mới nhất ở Đà Nẵng
Đà Nẵng       27/10/2026
Đà Nẵng       24/10/2026
    ...
Đồng Nai      29/10/2026
Đồng Nai      26/10/2026
    ...
Đây là cách hình dung index (province, listed_at DESC): tỉnh đứng trước, ngày đăng từ mới đến cũ đứng sau. Index là một cấu trúc riêng để tìm xe; nó không sắp xếp lại các dòng trong bảng.
Nếu bạn chỉ muốn 20 xe mới nhất của Đà Nẵng, công việc rất đơn giản: mở đúng nhóm Đà Nẵng, đọc từ trên xuống và dừng khi đủ 20 xe. Mốc 2025-01-01 giúp bỏ những xe quá cũ; nếu chưa đủ 20 xe trước mốc này thì kết quả sẽ có ít hơn 20 dòng.
Đó chính là điều ta muốn PostgreSQL làm. Nhưng trước khi tạo index, nó chưa có danh sách được xếp như vậy.
Không có index: tìm được 20 xe vẫn chưa thể dừng
Các dòng trong bảng không được lưu theo thứ tự ngày đăng. Xe mới nhất có thể nằm tận cuối bảng. Dù PostgreSQL đã thấy 20 xe Đà Nẵng, nó vẫn phải tiếp tục đọc: biết đâu những dòng chưa xem còn xe mới hơn?
Vì vậy, với kế hoạch quét bảng trong phép thử, PostgreSQL phải:
- Đọc toàn bộ bảng và tìm các xe Đà Nẵng đăng từ năm 2025.
- So ngày đăng để giữ lại 20 xe mới nhất.
- Trả 20 xe đó cho trang web.
Bước so ngày được gọi là Sort. Với LIMIT 20, PostgreSQL có thể dùng top-N heapsort để chỉ giữ 20 ứng viên tốt nhất trong bộ nhớ, nhưng vẫn phải xem hết dữ liệu cần xét.
Bảng thử có dung lượng khoảng 1,5 GB. Truy vấn không có index phù hợp phải quét 192.308 page (khối dữ liệu, thường 8 KB mỗi page) và mất khoảng 370 ms, dù kết quả chỉ có 20 xe.
Có index: PostgreSQL đọc đúng nhóm rồi dừng
Ta tạo danh sách đã xếp sẵn đó bằng B-tree index:
CREATE INDEX vehicles_prov_listed_idx
ON vehicles (province, listed_at DESC); 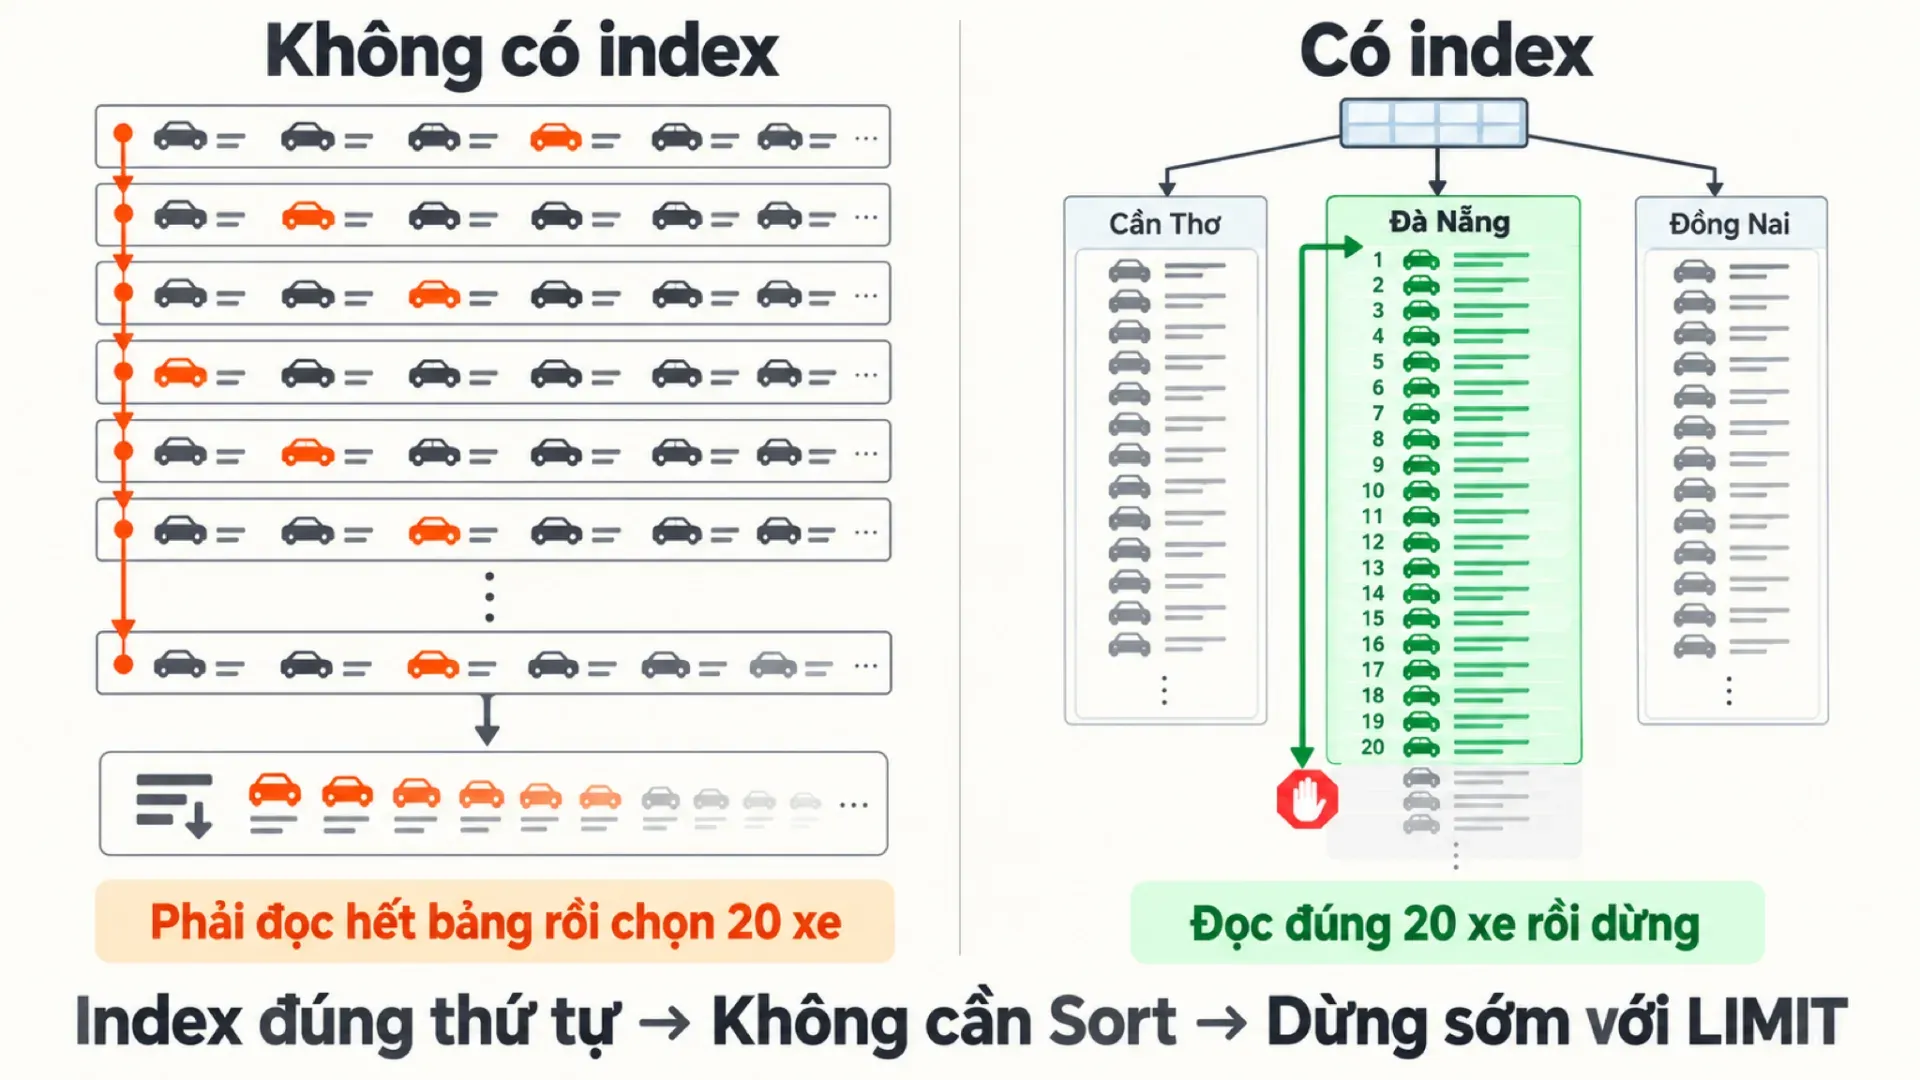
Chạy lại chính câu SQL đầu bài. Lần này PostgreSQL tìm đến nhóm Đà Nẵng trong index, lấy các xe theo ngày từ mới đến cũ và dừng khi đủ 20 dòng. Nó không cần quét hết hơn 67 nghìn xe phù hợp, cũng không cần bước Sort. Index vẫn chứa cả xe cũ; PostgreSQL chỉ không phải đọc đến chúng khi đã lấy đủ 20 xe.
Kế hoạch thực thi cho thấy:
Đọc kết quả EXPLAIN
-
Limit (actual rows=20.00 loops=1)Đã có 20 xe, không cần đọc tiếp. -
-> Index Scan using vehicles_prov_listed_idx on vehiclesTìm trong nhóm Đà Nẵng theo ngày mới nhất trước; không có bước Sort. -
Index Cond: ((province = 'Đà Nẵng'::text) AND (listed_at >= '2025-01-01 00:00:00+07'::timestamp with time zone))Index giúp giới hạn đúng tỉnh và mốc ngày. -
Buffers: shared hit=12 read=315 lượt truy cập page của index và bảng trong phép thử, thay vì quét 192.308 page.
Thời gian thực thi trong cùng phép thử giảm xuống dưới 0,1 ms.
Index làm
ORDER BY ... LIMITnhanh hơn vì nó đã có đúng thứ tự mà câu hỏi cần. PostgreSQL lấy đủ 20 xe rồi dừng, không phải tự sắp xếp lại.
Tại sao lấy 20 xe mới nhất toàn quốc lại khác?
Giờ người dùng bỏ chọn tỉnh, chỉ muốn 20 xe mới nhất trên cả nước:
SELECT id, listed_at FROM vehicles
WHERE listed_at >= '2025-01-01'
ORDER BY listed_at DESC LIMIT 20;
Nhìn lại danh sách ở đầu bài: xe Đà Nẵng được xếp mới trước cũ trong nhóm Đà Nẵng, nhưng xe Đồng Nai cũng có nhóm riêng. Xe mới nhất toàn quốc có thể ở bất kỳ nhóm nào.
Nếu chỉ lấy 20 mục đầu của index, ta sẽ lấy xe của một tỉnh, không phải 20 xe mới nhất toàn quốc. PostgreSQL cần xét ngày đăng giữa các tỉnh, nên index (province, listed_at DESC) không thể giúp bỏ bước sắp xếp theo cách vừa làm ở Đà Nẵng.
Với trang thường xuyên hỏi xe mới nhất không phân biệt tỉnh, index bắt đầu bằng ngày đăng sẽ hợp hơn:
CREATE INDEX vehicles_listed_idx ON vehicles (listed_at DESC);Nghĩa là không có một index tốt nhất cho mọi câu SQL. Câu hỏi lọc theo tỉnh và câu hỏi không lọc tỉnh cần thứ tự index khác nhau để lấy kết quả sớm.
Mở rộng: skip scan trong PostgreSQL 18
Không chọn tỉnh, index còn dùng được không?
Thiếu điều kiện tỉnh không có nghĩa index (province, listed_at DESC) luôn vô dụng. Xét một câu hỏi khác: Có bao nhiêu xe đăng từ ngày 29/09/2026 trên cả nước?
EXPLAIN (ANALYZE, BUFFERS)
SELECT count(*) FROM vehicles WHERE listed_at >= '2026-09-29';
Câu này chỉ cần đếm, không yêu cầu 20 xe mới nhất theo thứ tự toàn quốc. PostgreSQL 18 có thể dùng skip scan: lần lượt tìm đến đoạn ngày phù hợp trong từng nhóm tỉnh, bỏ qua phần lớn xe cũ, thay vì đi qua toàn bộ index.
Trong phép thử với 13 tỉnh, phần quét index của kế hoạch là:
Đọc kết quả EXPLAIN
-
Index Only Scan using vehicles_prov_listed_idx on vehicles (actual rows=1768.00 loops=1)Quét các mục phù hợp qua index để phục vụ phép đếm. -
Index Cond: (listed_at >= '2026-09-29 00:00:00+07'::timestamp with time zone)Chỉ có điều kiện ngày, không có điều kiện tỉnh. -
Index Searches: 1414 lần tìm vị trí trong index, không phải 14 tỉnh. -
Buffers: shared hit=19 read=4059 lượt truy cập page trong phép thử.
Cách này có ích khi số nhóm ở cột đầu không quá nhiều. Nếu cột đầu có hàng triệu giá trị khác nhau, việc nhảy qua từng nhóm có thể tốn hơn cách quét khác, nên PostgreSQL không nhất thiết chọn skip scan.
Điểm cần phân biệt: skip scan giúp tìm các xe thỏa điều kiện ngày; nó không biến những nhóm tỉnh riêng biệt thành một danh sách xe được xếp theo ngày trên toàn quốc.
Từ đầu đến giờ, ta tìm theo giá trị có sẵn trong cột province và listed_at. Nhưng nếu điều kiện tìm kiếm biến đổi giá trị của cột, chẳng hạn lower(plate), chuyện sẽ khác.
Có index trên plate, sao lower(plate) vẫn quét cả bảng?
Nguồn bài viết (4)
- 11.4. Indexes and ORDER BY · PostgreSQL 18 Documentation
- 11.3. Multicolumn Indexes · PostgreSQL 18 Documentation
- E.6. Release 18 · PostgreSQL 18 Documentation
- 14.1. Using EXPLAIN · PostgreSQL 18 Documentation