Index Scan lấy dòng từ heap như thế nào?
Có địa chỉ dòng rồi, PostgreSQL lấy cả dòng thế nào?
PostgreSQL vừa đi qua ba page của cây index trên plate và tìm được biển số 47P-600.55 cùng địa chỉ (474,21).
Nhưng câu SELECT * cần đủ 12 cột của chiếc xe: hãng Honda, giá 205.000.000 đồng, tỉnh Quảng Ninh, ngày đăng, ghi chú của người bán… Trong index chỉ có biển số và địa chỉ dòng.
Có địa chỉ dòng rồi, PostgreSQL lấy cả dòng thế nào?
Địa chỉ (474,21) dẫn đến đâu?
Địa chỉ này gồm hai phần:
474là page số 474 của bảngvehicles.21là vị trí của mục địa chỉ dẫn đến dòng bên trong page đó.
PostgreSQL gọi phần lưu dữ liệu của bảng là heap. Khác với index, các dòng trong heap không được sắp xếp theo biển số hay id.
Khi đã có (474,21), PostgreSQL không cần tìm kiếm trong cả bảng. Nó truy cập thẳng page 474, rồi dùng mục địa chỉ số 21 để tìm dữ liệu dòng.
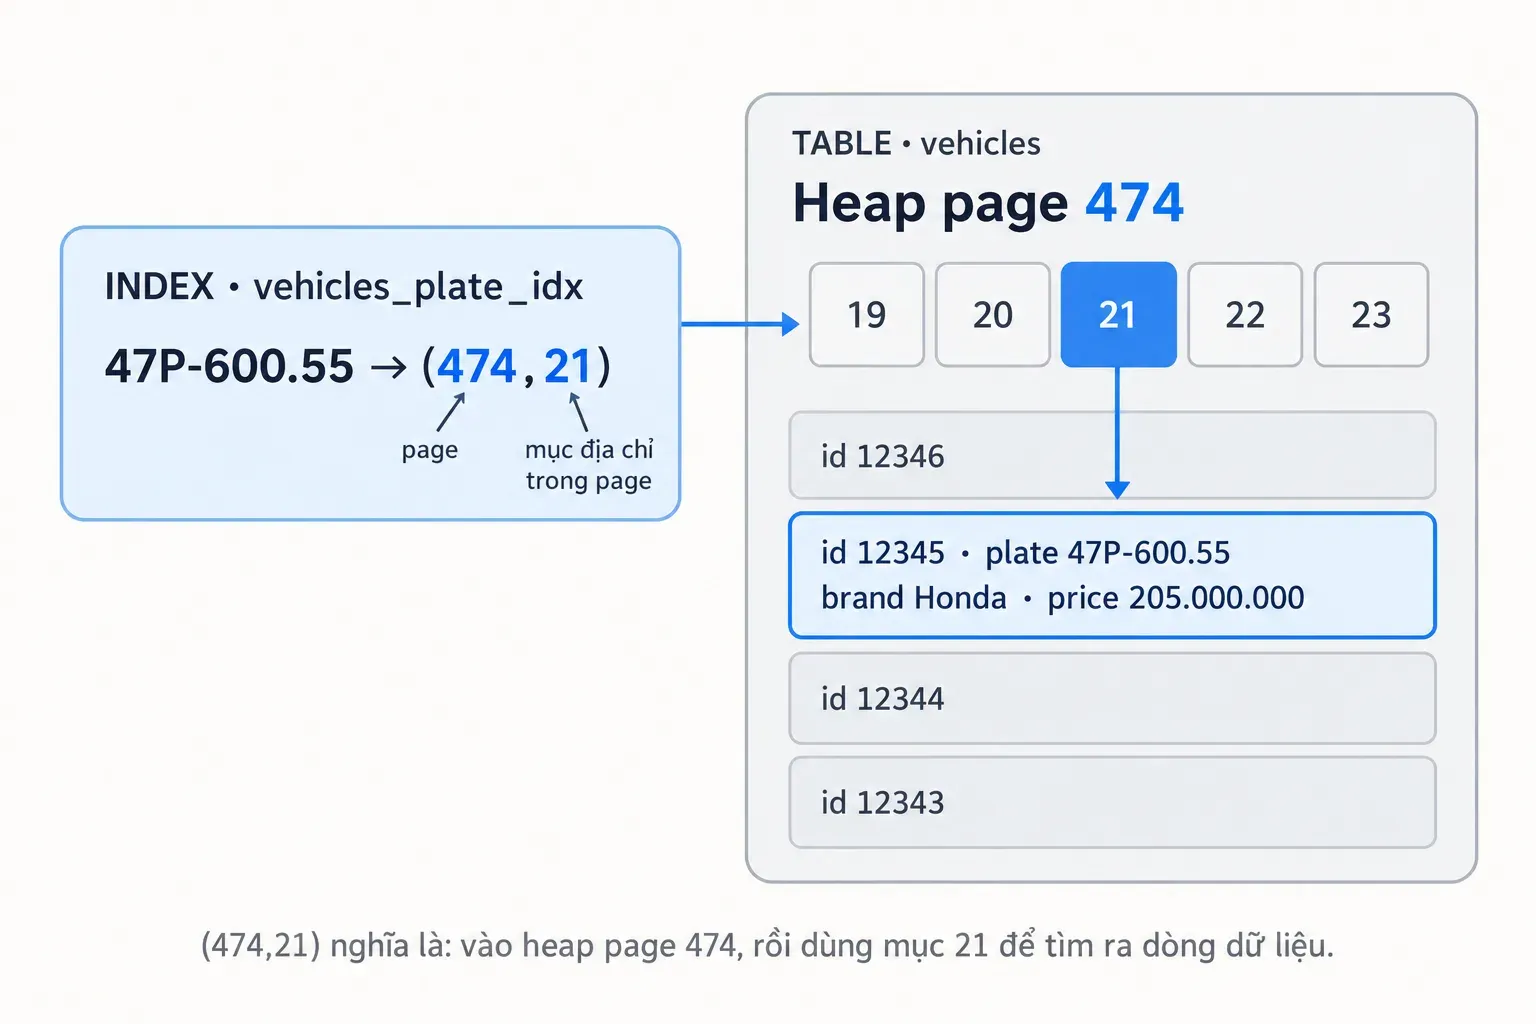
Nếu page 474 đã có trong bộ nhớ đệm (shared buffers), PostgreSQL sử dụng ngay. Nếu chưa, nó phải đọc page từ ổ đĩa vào bộ nhớ.
Đây là lý do trong ví dụ này, Index Scan truy cập tổng cộng bốn page: ba page của index để tìm địa chỉ, và một page của heap để lấy dữ liệu. Bốn page được truy cập không nhất thiết có nghĩa là bốn lần đọc từ ổ đĩa.
Nhưng có một vấn đề: tìm đúng địa chỉ chưa chắc đã tìm được phiên bản dữ liệu mà câu lệnh cần trả về.
Một chiếc xe có thể có hai phiên bản dữ liệu
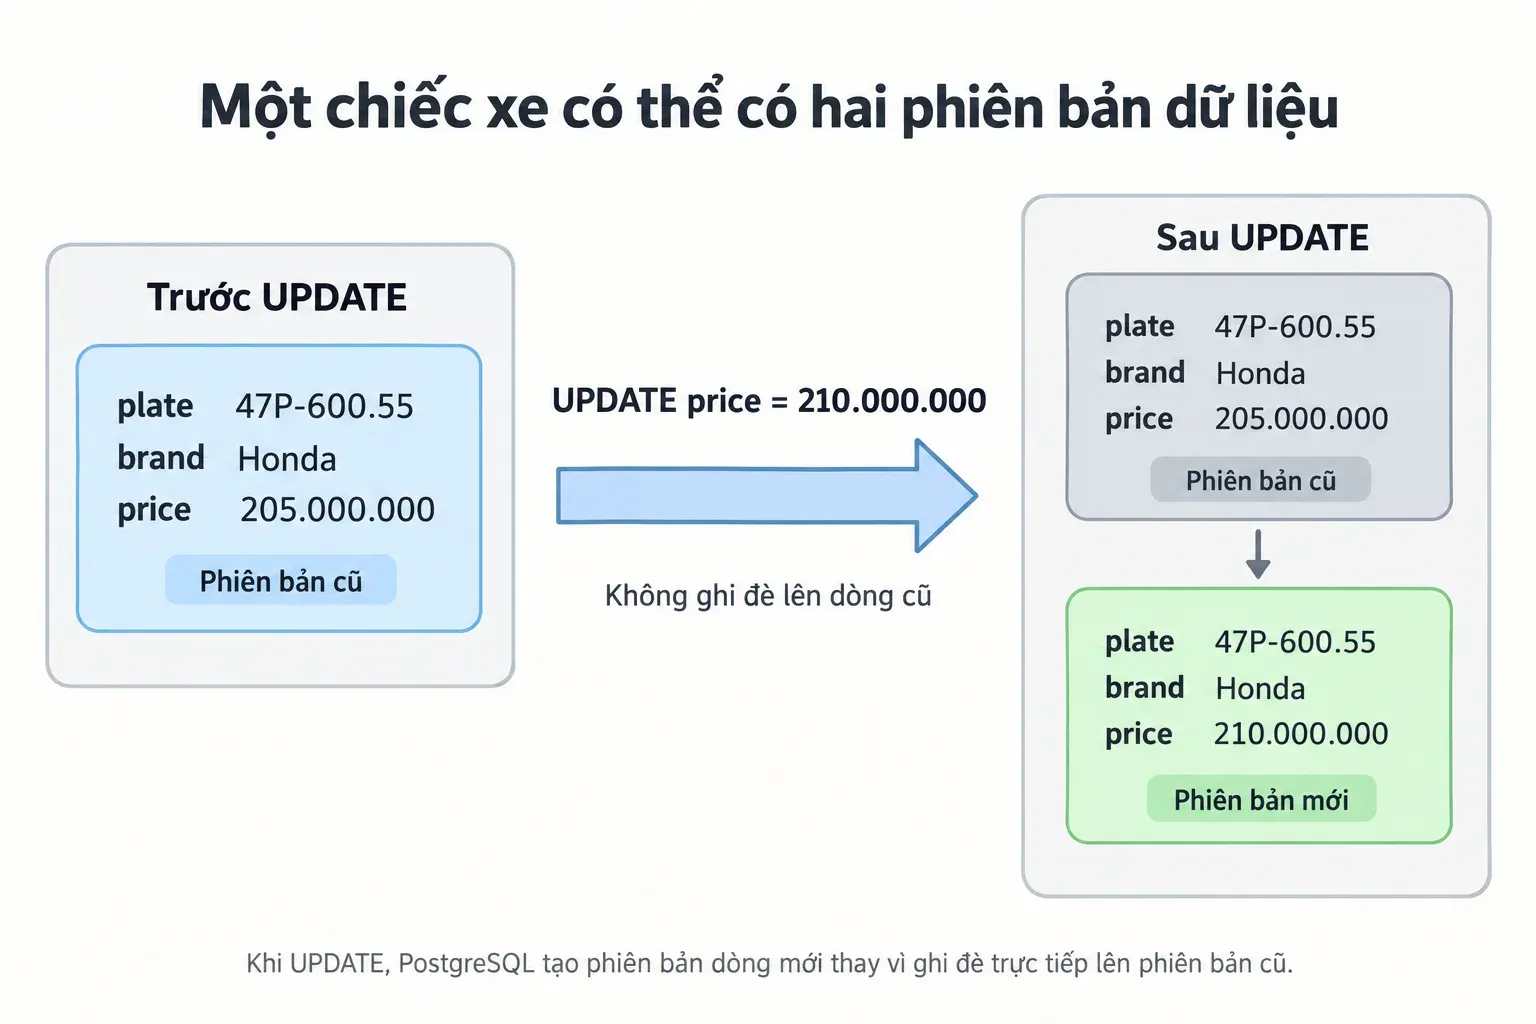
Giả sử chiếc Honda biển số 47P-600.55 đang được bán với giá 205 triệu đồng.
Người bán quyết định tăng giá lên 210 triệu đồng.
Khi chạy câu lệnh UPDATE, PostgreSQL không ghi đè giá 205 triệu thành 210 triệu ngay trên dòng cũ. Nó tạo thêm một phiên bản dòng (row version) chứa giá mới.
Trong heap lúc này có hai phiên bản của cùng một chiếc Honda:
- Phiên bản cũ: giá 205 triệu.
- Phiên bản mới: giá 210 triệu.
Tại sao PostgreSQL phải làm như vậy? Giữ một phiên bản rồi cập nhật giá chẳng phải đơn giản hơn sao?
Hãy xem chuyện gì xảy ra khi có hai người cùng tìm kiếm chiếc xe.
Hai người tìm cùng một chiếc xe, nhưng thấy hai mức giá khác nhau
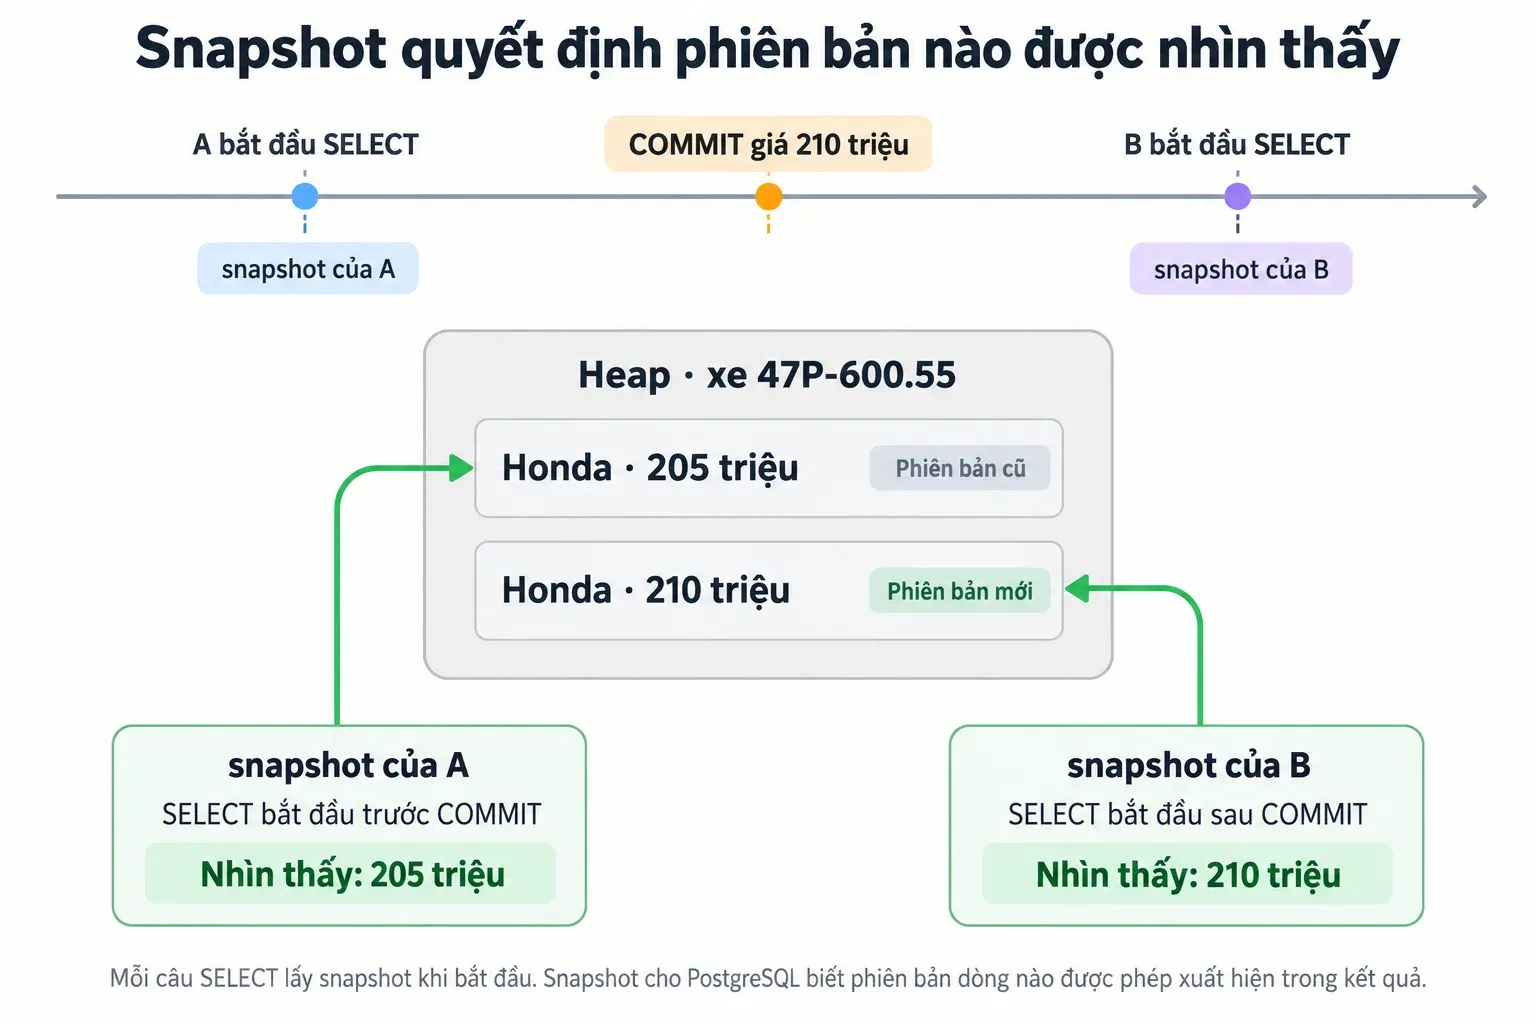
Người mua A bắt đầu chạy một câu SELECT khi chiếc xe vẫn có giá 205 triệu.
Ngay sau đó, người bán hoàn tất thay đổi giá thành 210 triệu và xác nhận transaction bằng COMMIT.
Giả sử lúc này câu SELECT của A vẫn đang chạy và chưa đọc đến dữ liệu chiếc Honda trong heap.
Vậy A sẽ thấy giá 205 triệu hay 210 triệu?
Vẫn là 205 triệu.
Bởi vì tại thời điểm câu SELECT của A bắt đầu, giá đã được xác nhận gần nhất là 205 triệu. Việc người bán commit giá mới trong lúc câu lệnh đang chạy không làm thay đổi dữ liệu mà A được phép nhìn thấy.
Còn người mua B bắt đầu tìm kiếm sau khi người bán đã commit thì sẽ thấy giá 210 triệu.
Cùng một chiếc Honda, nhưng hai câu SELECT có thể trả về hai mức giá khác nhau, tùy vào thời điểm chúng bắt đầu.
Nếu PostgreSQL ghi đè và xóa ngay phiên bản 205 triệu, câu lệnh của A sẽ không còn dữ liệu cũ để đọc. Vì vậy, PostgreSQL phải giữ lại những phiên bản cũ chừng nào chúng còn có thể cần thiết.
A và B thấy phiên bản nào?
A bắt đầu SELECT Người bán COMMIT B bắt đầu SELECT
Heap · Xe 47P-600.55
- Honda · 205 triệuPhiên bản cũ
- Honda · 210 triệuPhiên bản mới
SELECT của A 205 triệu
A bắt đầu trước COMMIT, nên snapshot của A chưa có giá mới.
Cơ chế cho phép nhiều phiên bản dữ liệu cùng tồn tại được gọi là MVCC (Multi-Version Concurrency Control).
Nhưng PostgreSQL dựa vào đâu để biết A phải thấy phiên bản 205 triệu, còn B phải thấy 210 triệu?
PostgreSQL quyết định phiên bản nào được nhìn thấy như thế nào?
Khi một câu SELECT bắt đầu, PostgreSQL xác định những thay đổi nào mà câu lệnh đó được phép nhìn thấy. Thông tin này được gọi là ảnh chụp dữ liệu (snapshot).
Snapshot không phải bản sao của toàn bộ bảng. Nó là thông tin giúp PostgreSQL xác định transaction nào đã hoàn tất và phiên bản dòng nào được phép xuất hiện trong kết quả.
Ở mức cô lập mặc định Read Committed, mỗi câu SELECT có snapshot riêng khi bắt đầu.
Mỗi phiên bản dòng trong heap cũng lưu thông tin về transaction đã tạo ra hoặc thay thế nó.
Khi đọc heap, PostgreSQL kết hợp thông tin trên phiên bản dòng với snapshot của câu lệnh:
- Nếu phiên bản phù hợp với snapshot, PostgreSQL có thể trả về dữ liệu đó.
- Nếu phiên bản không phù hợp, PostgreSQL bỏ qua nó.
Quay lại Index Scan ban đầu.
Index trên plate đã giúp PostgreSQL tìm được địa chỉ (474,21). Nhưng index không lưu thông tin để xác định phiên bản dòng nào được phép nhìn thấy.
PostgreSQL phải truy cập heap, kiểm tra phiên bản dòng tìm được và lấy những cột mà câu SELECT * cần. Trong trường hợp dòng đã được cập nhật, nó có thể phải kiểm tra các phiên bản liên quan trước khi quyết định kết quả.
Đó là lý do Index Scan không chỉ dùng heap để lấy các cột còn thiếu, mà còn để kiểm tra dữ liệu có được phép trả về hay không.
Với một chiếc xe, ví dụ ban đầu chỉ cần truy cập thêm một heap page.
Nhưng nếu index tìm thấy 1.000 chiếc xe thì sao? Các dòng có thể nằm rải rác trên hàng trăm heap page khác nhau. Một số nằm chung page, một số page đã có trong bộ nhớ, còn những page khác phải đọc từ ổ đĩa.
Nhiều dòng khớp thì Index Scan tốn gì?
Nguồn bài viết (4)
- 24.1. Routine Vacuuming · PostgreSQL 18 Documentation
- 11.9. Index-Only Scans and Covering Indexes · PostgreSQL 18 Documentation
- 13.1. Introduction (Concurrency Control) · PostgreSQL 18 Documentation
- 66.7. Heap-Only Tuples (HOT) · PostgreSQL 18 Documentation